
البنية التحتية للذكاء الاصطناعي
vLLM v0.32.0 ينقل توجيه الوكلاء إلى داخل محرك الاستدلال
يتوقف محرك الاستدلال عن كونه مضخة رموز غبية: قرارات التوجيه تُقيَّم داخل العملية معتمدة على كتل KV الدافئة بدلا من دفع ضريبة التمهيد مرتين. ما صدر في 18 أكتوبر وما الذي يجب تغييره في نشرك.
صياغة بمساعدة Muse؛ راجع المالك الحقائق والترجمات الثماني. هذه ليست مراجعة مستقلة بواسطة نموذج. كُتب هذا المقال بمساعدة الذكاء الاصطناعي ولم يخضع لمراجعة مستقلة. الأرقام وأوصاف الميزات من ملاحظات إصدار مشروع vLLM ما لم يُذكر خلاف ذلك؛ وتُستشهد التفسيرات الخارجية بشكل منفصل.
ما الذي صدر
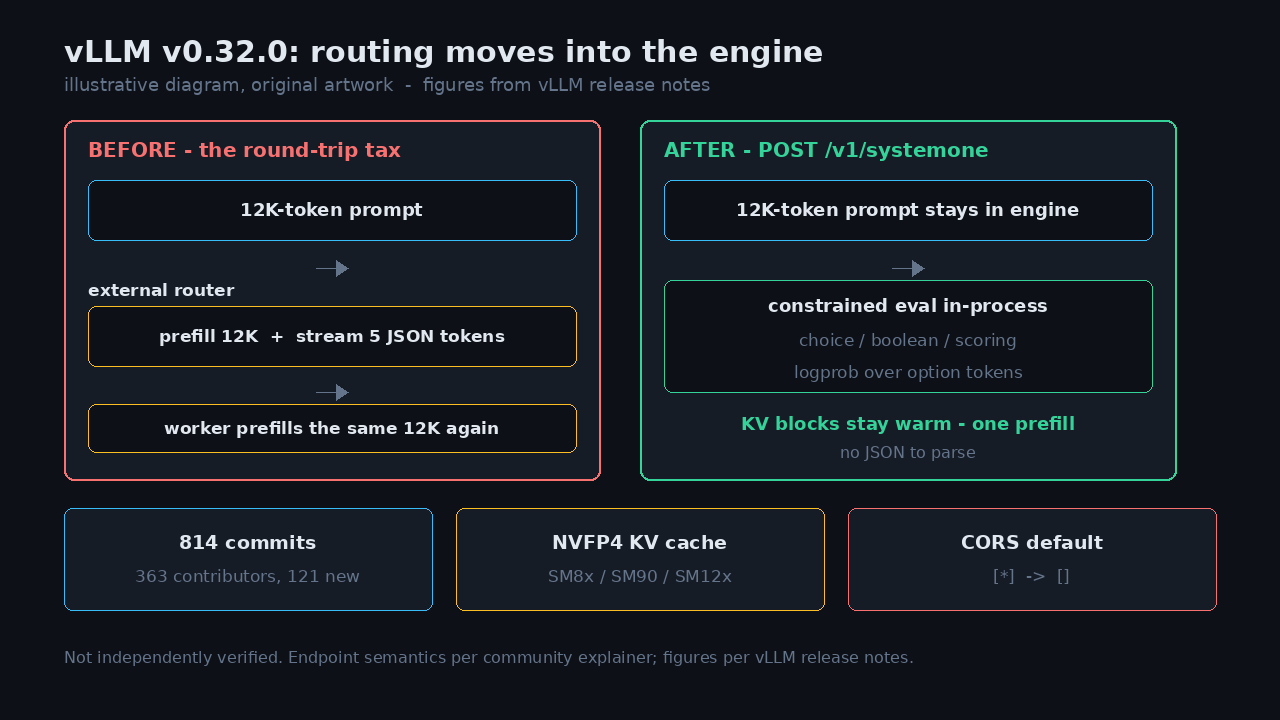
أصدر vLLM النسخة 0.32.0 في 18 أكتوبر 2026: 814 التزاما من 363 مساهما، 121 منهم جدد على المشروع، وفق ملاحظات الإصدار. أبرز الميزات نقطة نهاية جديدة للقرارات المنظمة، POST /v1/systemone، تجيب عن أسئلة الاختيار والمنطقية والتقييم فوق حالة منظمة دون الدخول في حلقة فك التشفير الذاتية الانحدار القياسية.
بقية الإصدار تُقرأ كسجل تغييرات لمشغلي البنية التحتية: ذاكرة KV من نوع NVFP4 على مزيد من معماريات GPU، وذاكرة KV من نوع FP8 افتراضيا في GLM-5.x، وModel Runner V2 افتراضيا على ROCm، وبدء تشغيل وخدمة أسرع، وقسم أمان يتصدره تغيير افتراضي في CORS سيفاجئ كل من يخدم vLLM مباشرة إلى المتصفح.
نقطة النهاية /v1/systemone
الواجهة صغيرة: ترسل موجها مع مخطط من نوع choice وقائمة خيارات، فيعيد الخادم القرار. ملاحظات الإصدار تفعّلها افتراضيا وتشير إلى أنها تعمل أيضا على clef-omni من Cloudflare وd1-3B من LiquidAI وDiffusionGemma — نماذج صغيرة، وهي بالضبط ما تختاره لموجه بوابي.
المثير للاهتمام ما لا يفعله المحرك. لا حلقة فك تشفير ذاتية انحدار، ولا خمسة رموز JSON بانتظار التحليل، ولا رموز مسودة من فك التشفير التخميني. يُقيَّم القرار داخل عملية المحرك، فوق حالة كتل KV فيها دافئة أصلا. هذه هي الرهان كله: يتوقف التوجيه عن كونه رحلة ذهاب وعودة ويصبح تقييما في الموقع.
ضريبة رحلة الذهاب والعودة
تخيل حلقة الفرز النموذجية للوكيل. يصل موجه من 12000 رمز: تعليمات النظام، وسياق مساحة العمل، ومخرجات الأدوات الأخيرة، وطلب المستخدم الأحدث. قبل إنفاق نموذج 70B عليه، تريد قرار توجيه رخيصا: هل يحتاج هذا تنفيذ shell؟ وهل هو آمن؟ وأي مخطط أدوات يجب تركيبه؟
كانت الإجابة القياسية استدعاء توجيه منفصل: تمهيد الرموز الـ12000 نفسها على نموذج صغير، وبث خمسة رموز JSON، وتحليلها، ثم الطلب الحقيقي — وتمهيد تلك الرموز الـ12000 مرة أخرى إذا طُردت ذاكرة البادئات أو تغير العامل. تدفع ضريبة التمهيد مرتين مقابل سؤال منطقي واحد، ثم تبني طبقات Redis وتوجيها لاصقا لتتوقف حزمتك عن محاربة نفسها.
نقل القرار إلى داخل المحرك رد على هذا الألم تحديدا. إذا قيّم الموجه حيث تعيش كتل KV، تبقى البادئة مثبتة في كتل PagedAttention ويمكن للاستدعاء التالي أن يصيب ذاكرة البادئات بدلا من إعادة حساب الانتباه. كم توفر يعتمد على حركة مرورك — لكن الضريبة التي يزيلها حقيقية.
ذاكرة KV منخفضة الدقة في كل مكان
الموضوع الثاني كثافة الذاكرة. تعمل ذاكرة KV من نوع NVFP4 الآن على SM8x وSM90 وSM12x (مع فك تشفير XQA على SM12x)، ويستخدم GLM-5.x افتراضيا ذاكرة KV من نوع FP8 على SM100، والتي تقول الملاحظات إنها تخفض ذاكرة KV لكل رتبة إلى النصف مع زيادة إنتاجية 2.3–5.5% بتكلفة TTFT من 7–11% في قياس طلب السحب. وعلى ROCm، تعد ذاكرة ultraquant من 4 بت بكثافة ضعف FP8 تقريبا.
هذه قياسات المشروع الخاصة، وليست قياسات مستقلة، والصفقة دائما واحدة: ذاكرة أقل لكل رمز مقابل مخاطرة جودة أو زمن استجابة يجب قياسها على حملك الخاص. لكن الاتجاه لا لبس فيه: المورد النادر في الخدمة هو ذاكرة KV، وكل إصدار يبذل جهدا أكبر لضغطها.
لغم الترقية: CORS
التغيير الأرجح أن يوقظك ليلا ليس ميزة أصلا. يبدّل vLLM 0.32 القيمة الافتراضية لـ --allowed-origins من ["*"] إلى []: لن تسمح المتصفحات بعد الآن لأي موقع باستدعاء خادم النماذج افتراضيا. هبط التغيير في 11 أكتوبر ودخل 0.32 عبر مرشحات الإصدار؛ فالنسخة 0.31 — وكل النسخ حتى 0.6 — ما زالت تجيب Access-Control-Allow-Origin: *.
إذا كانت صفحة ويب من مصدر آخر تتحدث مباشرة مع خادم vLLM لديك — واجهة دردشة داخلية، أو ملعب على منفذ آخر، أو واجهة دفتر ملاحظات أمامية — فستكسرها الترقية حتى تسرد المصادر الدقيقة. المتصلون من الخادم لا يتأثرون: curl وحزم SDK والبوابات لا تستخدم CORS. على أي حال، نفّذ فحص التمهيد المسبق ضد كل نقطة نهاية تملكها قبل الترقية، وأبق مفتاح API مفعّلا.
ماذا يعني ذلك لحزمتك
لبناة الوكلاء، الإشارة عن مكان منطق إطار العمل. كانت الحدود بين خادم الاستدلال وإطار الوكيل نظيفة: الخادم يبث البايتات، والإطار يدير إعادات المحاولة وتحليل الأدوات وآلات الحالة. يمتص vLLM الآن أجزاء الإطار التي تلمس حالة المحرك الساخنة: تحليل كتل الاستدلال، وتحليل استدعاءات الأدوات، والآن قرارات التوجيه.
تبقى التحفظات الصادقة سارية. قصة الآلية — أخذ العينات المقيد فوق رموز الخيارات، والتقييم بالاحتمالات اللوغاريتمية، والاحتفاظ بالذاكرة — من مقال مجتمعي لا من ملاحظات الإصدار، والملاحظات نفسها تكتب نوع السؤال الأوسط «noul». عامل الدلالات صحيحة الاتجاه حتى تقرأ طلب السحب.
عمليا: إذا كان متصفح يتحدث مع vLLM، اضبط مصادرك قبل الترقية لا بعدها. وإذا كان موجه الوكلاء لديك اليوم قفزة HTTP منفصلة، فقِس كم مرة تنجو بادئته حتى الاستدعاء التالي: هذا الرقم هو ما يريد /v1/systemone إزالته. وكما هو معتاد دائما: تحقق من أرقام الإنتاجية الخاصة بالمورّد على حركتك الخاصة قبل إعادة تحجيم أي شيء.
المصادر وقراءات إضافية
راجع المالك سجلات المصادر؛ ولا يُدّعى إجراء تحقق مستقل من الحقائق أو مراجعة مستقلة بواسطة نموذج.
- ملاحظات إصدار مشروع vLLM (GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- أخبار الذكاء الاصطناعي اليومية من olud.ai
olud.ai
Recorded publication date ·
Recorded verification time ·
- المدونة التقنية لـ Reid Marlow
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- مقال DEV Community عن CORS
DEV Community
Recorded publication date ·
Recorded verification time ·