
Infraestrutura de IA
vLLM v0.32.0 coloca o roteamento de agentes dentro do motor de inferência
O motor de inferência deixa de ser uma bomba de tokens burra: as decisões de roteamento passam a ser avaliadas no processo, reutilizando blocos KV quentes em vez de pagar o imposto de prefill duas vezes. O que saiu em 18 de outubro e o que mudar no seu deploy.
Redação assistida por Muse; o proprietário revisou os fatos e as oito traduções. Não se trata de revisão independente por um modelo. Este artigo foi escrito com assistência de IA e não foi revisado de forma independente. Números e descrições de recursos são as notas de lançamento do projeto vLLM, salvo indicação em contrário; explicações de terceiros são citadas separadamente.
O que saiu
O vLLM publicou a versão 0.32.0 em 18 de outubro de 2026: 814 commits de 363 colaboradores, 121 deles novos no projeto, segundo as notas de lançamento. A novidade principal é um novo endpoint de decisões estruturadas, POST /v1/systemone, que responde perguntas de escolha, booleanas e de pontuação sobre um estado estruturado sem entrar no loop padrão de decodificação autorregressiva.
O resto do lançamento parece um changelog para operadores de infraestrutura: cache KV NVFP4 em mais arquiteturas de GPU, cache KV FP8 como padrão no GLM-5.x, Model Runner V2 como padrão no ROCm, inicialização e atendimento mais rápidos, e uma seção de segurança encabeçada por uma mudança de padrão de CORS que vai surpreender quem serve vLLM direto no navegador.
O endpoint /v1/systemone
A interface é pequena: você envia um prompt mais um esquema do tipo choice com uma lista de opções, e o servidor devolve a decisão. As notas de lançamento o ativam por padrão e observam que também roda no clef-omni da Cloudflare, no d1-3B da LiquidAI e no DiffusionGemma: modelos pequenos, exatamente os que você escolheria para um roteador de controle.
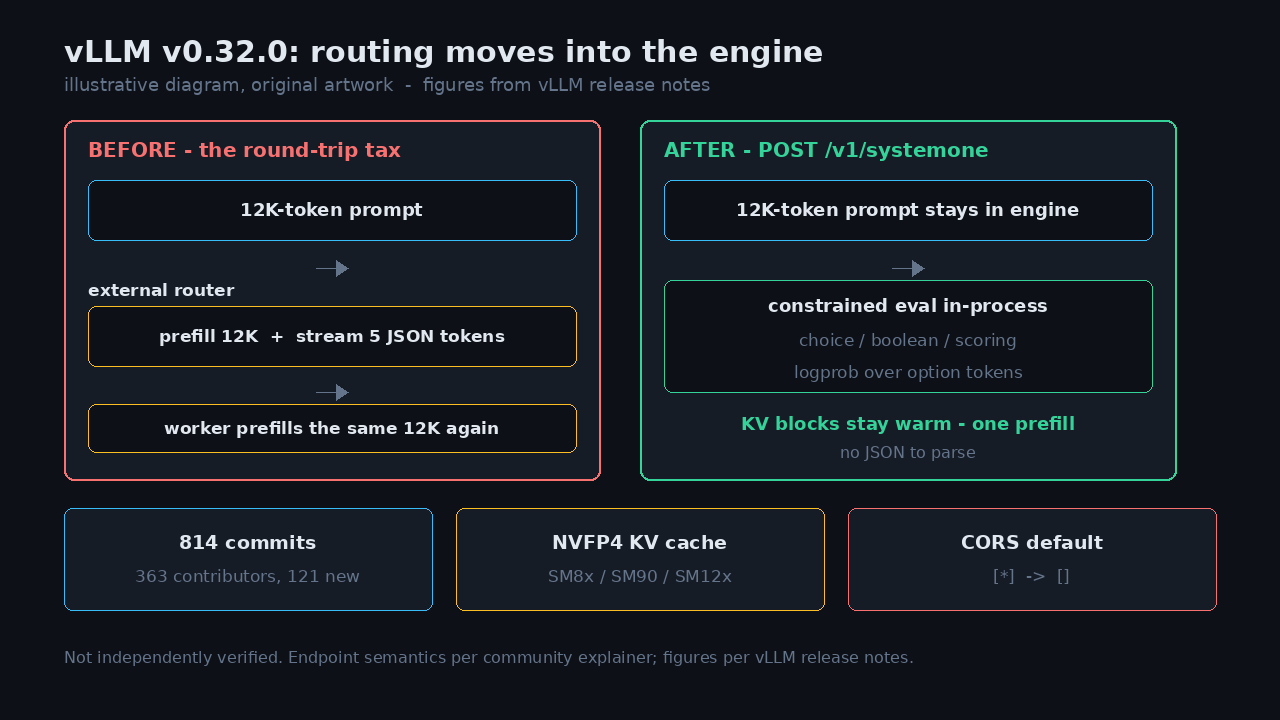
O interessante é o que o motor não faz. Não há loop de decodificação autorregressiva, nem cinco tokens de JSON para analisar, nem tokens de rascunho da decodificação especulativa. A decisão é avaliada no processo do motor, sobre um estado cujos blocos KV já estão quentes. Essa é toda a aposta: o roteamento deixa de ser uma ida e volta e vira uma avaliação no local.
O imposto da ida e volta
Imagine o loop de triagem típico de um agente. Chega um prompt de 12.000 tokens: instruções do sistema, contexto do workspace, saídas recentes de ferramentas, o último pedido do usuário. Antes de gastar um modelo de 70B nele, você quer uma decisão de roteamento barata: isso precisa de execução de shell?, é seguro?, qual esquema de ferramenta montar?
A resposta padrão tem sido uma chamada de roteamento separada: prefill dos mesmos 12.000 tokens num modelo pequeno, streaming de cinco tokens de JSON, parse, e então a requisição real — e outro prefill desses 12.000 tokens se o cache de prefixos foi despejado ou o worker mudou. Você paga o imposto de prefill duas vezes por uma pergunta booleana, e depois constrói camadas de Redis e roteamento fixo para sua própria pilha parar de brigar consigo mesma.
Mover a decisão para dentro do motor responde a essa dor específica. Se o roteador avalia onde os blocos KV moram, o prefixo fica fixado nos blocos do PagedAttention e a chamada seguinte pode acertar o cache de prefixos em vez de recalcular a atenção. Quanto você economiza depende do seu tráfego, mas o imposto que ele elimina é real.
Cache KV de baixa precisão em toda parte
O segundo tema é densidade de memória. O cache KV NVFP4 agora roda em SM8x, SM90 e SM12x (com decodificação XQA em SM12x), e o GLM-5.x usa por padrão um cache KV FP8 em SM100, que segundo as notas corta pela metade a memória KV por rank com 2,3–5,5% a mais de throughput ao custo de 7–11% de TTFT no benchmark do PR. No ROCm, um cache ultraquant de 4 bits promete cerca do dobro da densidade do FP8.
São números dos próprios benchmarks do projeto, não medições independentes, e a troca é sempre a mesma: menos memória por token em troca de um risco de qualidade ou latência que você deve medir na sua própria carga. Mas a direção é inequívoca: o recurso escasso no serving é a memória KV, e cada release dedica mais esforço a comprimi-la.
A mina da atualização: CORS
A mudança com mais chances de te acordar de madrugada não é um recurso. O vLLM 0.32 troca o padrão de --allowed-origins de ["*"] para []: os navegadores deixam de permitir que qualquer site chame seu servidor de modelos por padrão. A mudança chegou em 11 de outubro e entrou na 0.32 via release candidates, então a 0.31 — e todas as versões até a 0.6 — ainda respondem Access-Control-Allow-Origin: *.
Se uma página de outra origem fala direto com seu servidor vLLM — uma UI de chat interna, um playground em outra porta, um frontend de notebook — a atualização a quebra até você listar as origens exatas. Chamadores de servidor não são afetados: curl, SDKs e gateways não fazem CORS. De todo modo, rode a checagem de preflight contra cada endpoint seu antes de atualizar, e mantenha a API key ligada.
O que significa para sua pilha
Para quem constrói agentes, o sinal é sobre onde a lógica do framework deve morar. A fronteira entre servidor de inferência e framework de agentes costumava ser limpa: o servidor transmitia bytes, o framework cuidava de retries, parse de ferramentas e máquinas de estado. O vLLM está absorvendo as partes do framework que tocam o estado quente do motor: parse de blocos de raciocínio, parse de tool calls e agora decisões de roteamento.
As ressalvas honestas continuam valendo. A história do mecanismo — amostragem restrita sobre tokens de opção, pontuação por logprob, retenção de cache — vem de um artigo da comunidade, não das notas de lançamento, e as próprias notas escrevem o tipo de pergunta do meio como «noul». Trate a semântica como direcionalmente correta até ler o PR.
Na operação: se algum navegador fala com o vLLM, configure suas origens antes de atualizar, não depois. Se seu roteador de agentes hoje é um salto HTTP separado, meça quantas vezes o prefixo dele sobrevive até a chamada seguinte: esse número é o que o /v1/systemone quer eliminar. E como sempre, verifique os números de throughput do fornecedor no seu próprio tráfego antes de redimensionar qualquer coisa.
Fontes e leituras
O proprietário revisou os registros de fontes; não se afirma verificação independente dos fatos nem revisão independente por um modelo.
- notas de lançamento do projeto vLLM (GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- notícias diárias de IA da olud.ai
olud.ai
Recorded publication date ·
Recorded verification time ·
- blog técnico de Reid Marlow
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- artigo da DEV Community sobre CORS
DEV Community
Recorded publication date ·
Recorded verification time ·