
Infraestructura de IA
vLLM v0.32.0 lleva el enrutamiento de agentes dentro del motor de inferencia
El motor de inferencia deja de ser una bomba de tokens tonta: las decisiones de enrutamiento se evalúan en el proceso, reutilizando bloques KV calientes en lugar de pagar el impuesto de prefill dos veces. Qué se publicó el 18 de octubre y qué cambiar en tu despliegue.
Redacción asistida por Muse; el propietario revisó los hechos y las ocho traducciones. No es una revisión independiente por un modelo. Este artículo se escribió con asistencia de IA y no ha sido revisado de forma independiente. Las cifras y descripciones de funciones son las notas de lanzamiento del proyecto vLLM salvo indicación contraria; las explicaciones de terceros se citan por separado.
Qué se publicó
vLLM publicó la versión 0.32.0 el 18 de octubre de 2026: 814 commits de 363 colaboradores, 121 de ellos nuevos en el proyecto, según las notas de lanzamiento del proyecto. La novedad principal es un nuevo endpoint de decisiones estructuradas, POST /v1/systemone, que responde preguntas de elección, booleanas y de puntuación sobre un estado estructurado sin entrar en el bucle de decodificación autorregresiva estándar.
El resto del lanzamiento parece un changelog para operadores de infraestructura: caché KV NVFP4 en más arquitecturas de GPU, caché KV FP8 como valor por defecto en GLM-5.x, Model Runner V2 como predeterminado en ROCm, arranque y servicio más rápidos, y una sección de seguridad encabezada por un cambio de CORS por defecto que sorprenderá a quien sirva vLLM directamente al navegador.
El endpoint /v1/systemone
La interfaz es pequeña: envías un prompt más un esquema del tipo choice con una lista de opciones, y el servidor devuelve la decisión. Las notas de lanzamiento lo activan por defecto y señalan que también funciona en clef-omni de Cloudflare, d1-3B de LiquidAI y DiffusionGemma: modelos pequeños, justo los que elegirías para un enrutador de control.
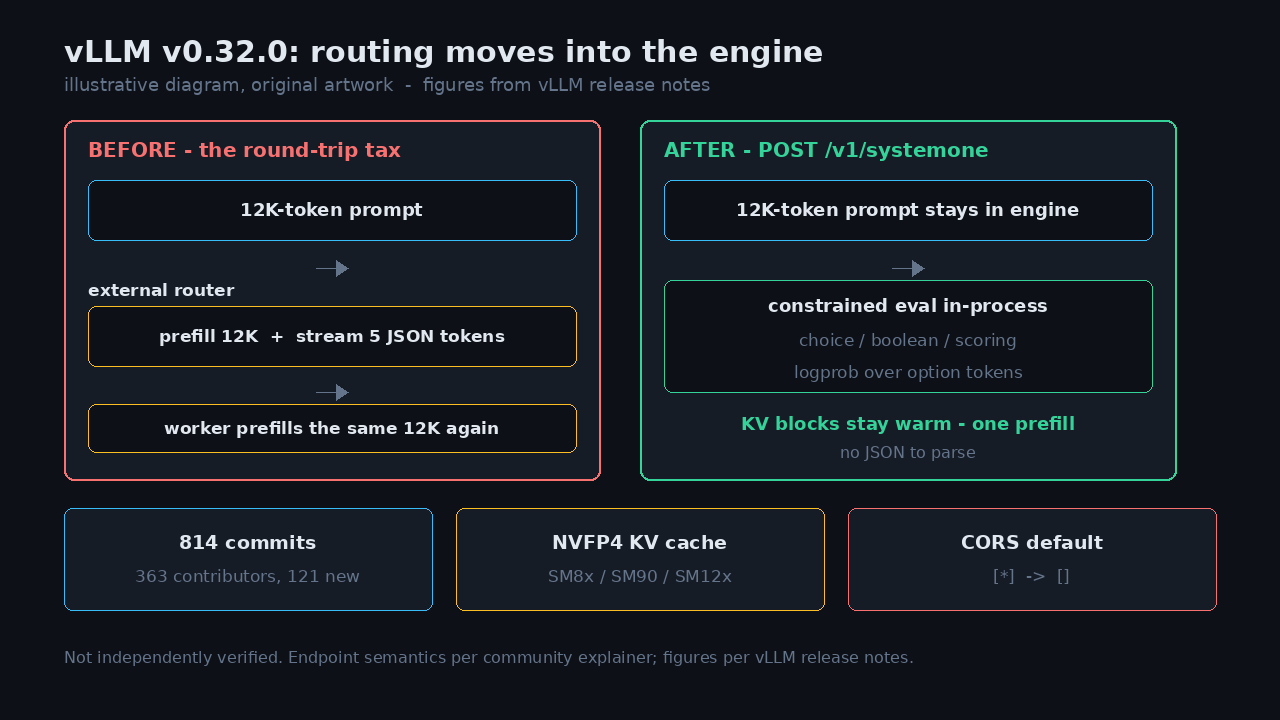
Lo interesante es lo que el motor no hace. No hay bucle de decodificación autorregresiva, ni cinco tokens de JSON que analizar, ni tokens borrador de la decodificación especulativa. La decisión se evalúa en el proceso del motor, sobre un estado cuyos bloques KV ya están calientes. Esa es toda la apuesta: el enrutamiento deja de ser un viaje de ida y vuelta y se convierte en una evaluación in situ.
El impuesto del viaje de ida y vuelta
Imagina el bucle de triaje típico de un agente. Llega un prompt de 12.000 tokens: instrucciones del sistema, contexto del espacio de trabajo, salidas recientes de herramientas, la última petición del usuario. Antes de gastarte un modelo de 70B en él, quieres una decisión de enrutamiento barata: ¿esto necesita ejecución de shell?, ¿es seguro?, ¿qué esquema de herramientas hay que montar?
La respuesta estándar ha sido una llamada de enrutamiento separada: prefill de los mismos 12.000 tokens en un modelo pequeño, streaming de cinco tokens de JSON, análisis, y luego la petición real — y otro prefill de esos 12.000 tokens si la caché de prefijos se expulsó o cambió el worker. Pagas el impuesto de prefill dos veces por una pregunta booleana, y luego construyes capas de Redis y enrutamiento fijo para que tu propia pila deje de pelear consigo misma.
Mover la decisión dentro del motor responde a ese dolor concreto. Si el enrutador evalúa donde viven los bloques KV, el prefijo queda fijado en los bloques de PagedAttention y la llamada siguiente puede acertar en la caché de prefijos en lugar de recalcular la atención. Cuánto ahorres depende de tu tráfico, pero el impuesto que elimina es real.
Caché KV de baja precisión en todas partes
El segundo tema es la densidad de memoria. La caché KV NVFP4 ahora funciona en SM8x, SM90 y SM12x (con decodificación XQA en SM12x), y GLM-5.x usa por defecto una caché KV FP8 en SM100, que según las notas reduce a la mitad la memoria KV por rank con un 2,3–5,5 % más de throughput a costa de un 7–11 % de TTFT en el benchmark del PR. En ROCm, una caché ultraquant de 4 bits promete el doble de densidad que FP8.
Son cifras de los benchmarks propios del proyecto, no mediciones independientes, y el trato es siempre el mismo: menos memoria por token a cambio de un riesgo de calidad o latencia que debes medir en tu propia carga. Pero la dirección es inequívoca: el recurso escaso en el servicio es la memoria KV, y cada versión dedica más esfuerzo a comprimirla.
La mina de la actualización: CORS
El cambio con más papeletas para despertarte no es una función. vLLM 0.32 cambia el valor por defecto de --allowed-origins de ["*"] a []: los navegadores ya no permitirán que cualquier sitio llame a tu servidor de modelos por defecto. El cambio llegó el 11 de octubre y entró en la 0.32 a través de las release candidates, así que la 0.31 —y todas las versiones hasta la 0.6— siguen respondiendo Access-Control-Allow-Origin: *.
Si una página web de otro origen habla directamente con tu servidor vLLM —una UI de chat interna, un playground en otro puerto, un frontend de notebook— la actualización la romperá hasta que listes los orígenes exactos. Los clientes de servidor no se ven afectados: curl, los SDK y las pasarelas no hacen CORS. En cualquier caso, ejecuta la comprobación de preflight contra cada endpoint que tengas antes de actualizar, y mantén la API key.
Qué significa para tu pila
Para quienes construyen agentes, la señal es dónde debe vivir la lógica del framework. La frontera entre el servidor de inferencia y el framework de agentes solía ser limpia: el servidor transmitía bytes, el framework gestionaba reintentos, análisis de herramientas y máquinas de estado. vLLM está absorbiendo las partes del framework que tocan el estado caliente del motor: análisis de bloques de razonamiento, análisis de llamadas a herramientas y ahora decisiones de enrutamiento.
Las salvedades honestas siguen valiendo. La historia del mecanismo —muestreo restringido sobre tokens de opción, puntuación por logprob, retención de caché— viene de un artículo comunitario, no de las notas de lanzamiento, y las propias notas escriben el tipo de pregunta intermedio como «noul». Trata la semántica como direccionalmente correcta hasta que leas el PR.
En lo operativo: si algún navegador habla con vLLM, configura tus orígenes antes de actualizar, no después. Si tu enrutador de agentes es hoy un salto HTTP separado, mide cuántas veces su prefijo sobrevive hasta la llamada siguiente: ese número es lo que /v1/systemone quiere eliminar. Y como siempre, verifica las cifras de throughput del proveedor en tu propio tráfico antes de redimensionar nada.
Fuentes y lecturas
El propietario revisó los registros de fuentes; no se afirma una verificación independiente de hechos ni una revisión independiente por un modelo.
- notas de lanzamiento del proyecto vLLM (GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- noticias diarias de IA de olud.ai
olud.ai
Recorded publication date ·
Recorded verification time ·
- blog técnico de Reid Marlow
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- artículo de DEV Community sobre CORS
DEV Community
Recorded publication date ·
Recorded verification time ·