
KI-Infrastruktur
vLLM v0.32.0 verlegt das Agenten-Routing in die Inference-Engine
Die Inference-Engine hört auf, eine dumme Token-Pumpe zu sein: Routing-Entscheidungen werden im Prozess evaluiert und nutzen warme KV-Blöcke, statt die Prefill-Steuer zweimal zu zahlen. Was am 18. Oktober erschienen ist und was Sie in Ihrem Deployment ändern müssen.
Entwurf mit Unterstützung von Muse; der Eigentümer hat die Fakten und alle acht Übersetzungen geprüft. Dies ist keine unabhängige Modellprüfung. Dieser Artikel wurde mit KI-Unterstützung geschrieben und nicht unabhängig geprüft. Zahlen und Funktionsbeschreibungen stammen aus den Release Notes des vLLM-Projekts, sofern nicht anders angegeben; Erklärungen Dritter werden separat zitiert.
Was erschienen ist
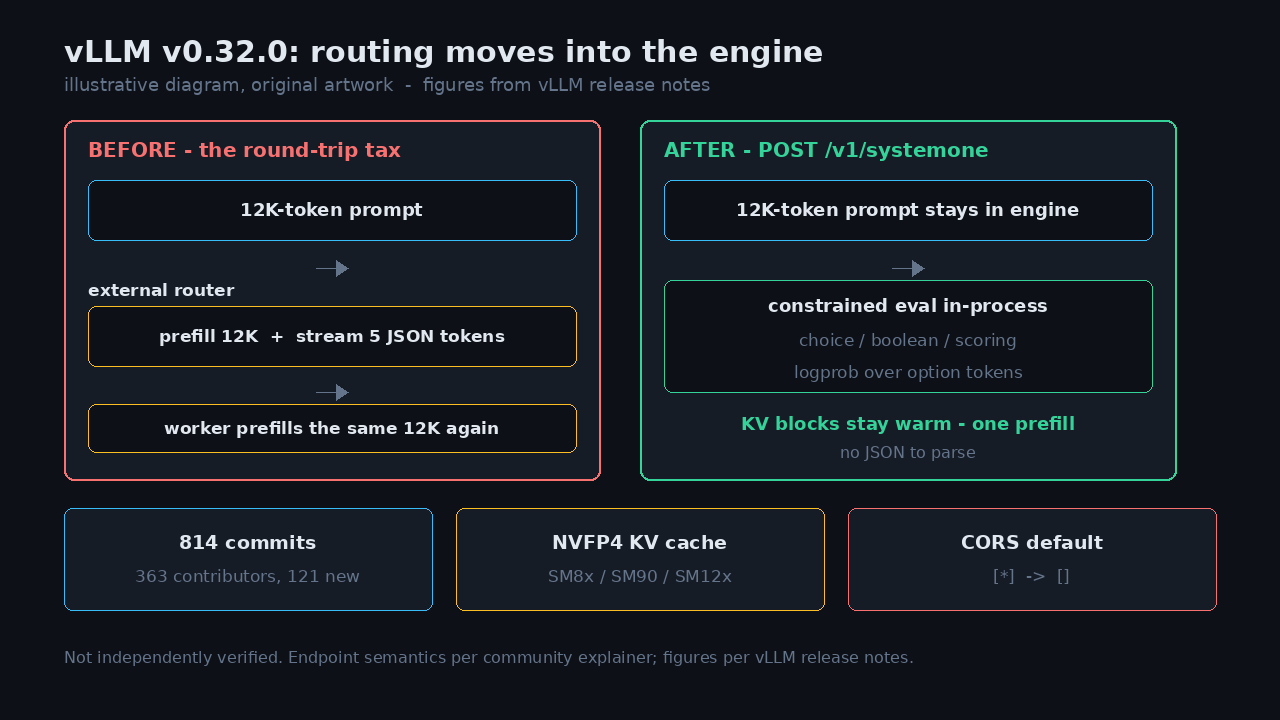
vLLM hat am 18. Oktober 2026 die Version 0.32.0 veröffentlicht: 814 Commits von 363 Mitwirkenden, davon 121 neu im Projekt, laut den Release Notes. Das Highlight ist ein neuer Endpoint für strukturierte Entscheidungen, POST /v1/systemone, der Choice-, Boolean- und Scoring-Fragen über einem strukturierten Zustand beantwortet, ohne in die Standard-Autoregressive-Decode-Schleife einzutreten.
Der Rest liest sich wie ein Changelog für Infrastrukturbetreiber: NVFP4-KV-Cache auf mehr GPU-Architekturen, FP8-KV-Cache als Standard für GLM-5.x, Model Runner V2 als Standard auf ROCm, schnellerer Start und schnelleres Serving, und ein Sicherheitsabschnitt, angeführt von einer CORS-Standardänderung, die jeden überraschen wird, der vLLM direkt an den Browser ausliefert.
Der Endpoint /v1/systemone
Die Schnittstelle ist klein: Sie senden einen Prompt plus ein Schema vom Typ choice mit einer Optionsliste, und der Server gibt die Entscheidung zurück. Die Release Notes aktivieren ihn per Default und vermerken, dass er auch auf Cloudflares clef-omni, LiquidAIs d1-3B und DiffusionGemma läuft — kleine Modelle, genau die, die man für einen Gating-Router wählen würde.
Das Interessante ist, was die Engine nicht tut. Keine autoregressive Decode-Schleife, keine fünf JSON-Tokens zum Parsen, keine Draft-Tokens aus dem spekulativen Decoding. Die Entscheidung wird im Engine-Prozess evaluiert, auf einem Zustand, dessen KV-Blöcke bereits warm sind. Das ist die ganze Wette: Routing hört auf, ein Round-Trip zu sein, und wird zu einer In-Place-Evaluierung.
Die Round-Trip-Steuer
Stellen Sie sich die typische Agenten-Triage-Schleife vor. Ein 12.000-Token-Prompt landet: Systemanweisungen, Workspace-Kontext, aktuelle Tool-Outputs, die neueste Nutzeranfrage. Bevor Sie ein 70B-Modell darauf ansetzen, wollen Sie eine billige Routing-Entscheidung: Braucht das Shell-Ausführung? Ist es sicher? Welches Tool-Schema soll gemountet werden?
Die Standardantwort war bisher ein separater Routing-Call: dieselben 12.000 Tokens auf einem kleinen Modell prefillsen, fünf JSON-Tokens streamen, parsen, dann die eigentliche Anfrage — und noch einmal 12.000 Tokens prefillsen, falls der Prefix-Cache verdrängt wurde oder der Worker gewechselt hat. Sie zahlen die Prefill-Steuer zweimal für eine Boolean-Frage und bauen danach Redis-Schichten und Sticky-Routing, damit der eigene Stack aufhört, gegen sich selbst zu kämpfen.
Die Entscheidung in die Engine zu verlegen, antwortet genau auf diesen Schmerz. Wenn der Router dort evaluiert, wo die KV-Blöcke leben, bleibt der Prefix in den PagedAttention-Blöcken gepinnt, und der Folge-Call kann den Prefix-Cache treffen, statt Attention neu zu berechnen. Wie viel Sie sparen, hängt von Ihrem Traffic ab — aber die Steuer, die er abschafft, ist real.
Low-Precision-KV-Cache überall
Das zweite Thema ist Speicherdichte. Der NVFP4-KV-Cache läuft nun auf SM8x, SM90 und SM12x (mit XQA-Decode auf SM12x), und GLM-5.x nutzt auf SM100 standardmäßig einen FP8-KV-Cache, der laut Notes den KV-Speicher pro Rank halbiert — bei 2,3–5,5 % mehr Durchsatz und 7–11 % TTFT-Kosten im Benchmark des PRs. Auf ROCm verspricht ein 4-Bit-Ultraquant-Cache etwa die doppelte Dichte von FP8.
Das sind die eigenen Benchmarks des Projekts, keine unabhängigen Messungen, und der Deal ist immer derselbe: weniger Speicher pro Token gegen ein Qualitäts- oder Latenzrisiko, das Sie auf Ihrer eigenen Last messen müssen. Aber die Richtung ist eindeutig: Die knappe Ressource im Serving ist der KV-Speicher, und jedes Release steckt mehr Aufwand in seine Kompression.
Die Upgrade-Landmine: CORS
Die Änderung, die Sie am ehesten nachts weckt, ist gar kein Feature. vLLM 0.32 stellt den Default von --allowed-origins von ["*"] auf [] um: Browser lassen standardmäßig keine beliebige Website mehr Ihren Modellserver aufrufen. Die Änderung landete am 11. Oktober und kam über die Release Candidates in die 0.32; die 0.31 — und alle Versionen zurück bis 0.6 — antworten weiterhin mit Access-Control-Allow-Origin: *.
Wenn eine Webseite anderer Origin direkt mit Ihrem vLLM-Server spricht — eine interne Chat-UI, ein Playground auf einem anderen Port, ein Notebook-Frontend — bricht das Upgrade sie, bis Sie die exakten Origins listen. Server-seitige Aufrufer sind nicht betroffen: curl, SDKs und Gateways machen kein CORS. Führen Sie in jedem Fall vor dem Upgrade den Preflight-Check gegen jeden Ihrer Endpoints aus und lassen Sie den API-Key an.
Was das für Ihren Stack bedeutet
Für Agentenbauer geht es um die Frage, wo Framework-Logik hingehört. Die Grenze zwischen Inference-Server und Agenten-Framework war früher sauber: Der Server streamte Bytes, das Framework kümmerte sich um Retries, Tool-Parsing und Zustandsmaschinen. vLLM absorbiert nun die Framework-Teile, die heißen Engine-State berühren: Reasoning-Block-Parsing, Tool-Call-Parsing und jetzt Routing-Entscheidungen.
Die ehrlichen Vorbehalte bleiben bestehen. Die Mechanismus-Geschichte — eingeschränktes Sampling über Options-Tokens, Scoring per Logprob, Cache-Retention — stammt aus einem Community-Artikel, nicht aus den Release Notes, und die Notes selbst schreiben den mittleren Fragetyp als «noul». Behandeln Sie die Semantik als richtungsweisend korrekt, bis Sie den PR gelesen haben.
Operativ: Wenn ein Browser mit vLLM spricht, setzen Sie Ihre Origins vor dem Upgrade, nicht danach. Wenn Ihr Agenten-Router heute ein separater HTTP-Hop ist, messen Sie, wie oft sein Prefix den Folge-Call überlebt: Diese Zahl ist es, was /v1/systemone eliminieren will. Und wie immer: Verifizieren Sie die Durchsatzzahlen des Anbieters auf Ihrem eigenen Traffic, bevor Sie irgendetwas neu dimensionieren.
Quellen und weitere Lektüre
Der Eigentümer hat die Quellenangaben geprüft; eine unabhängige Fakten- oder Modellprüfung wird nicht behauptet.
- Release Notes des vLLM-Projekts (GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- tägliche KI-News von olud.ai
olud.ai
Recorded publication date ·
Recorded verification time ·
- Technikblog von Reid Marlow
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- DEV-Community-Artikel zu CORS
DEV Community
Recorded publication date ·
Recorded verification time ·