
Infrastructure IA
vLLM v0.32.0 fait entrer le routage des agents dans le moteur d'inférence
Le moteur d'inférence cesse d'être une pompe à tokens idiote : les décisions de routage s'évaluent dans le processus, en réutilisant des blocs KV chauds au lieu de payer la taxe de prefill deux fois. Ce qui est sorti le 18 octobre et quoi changer dans votre déploiement.
Rédaction assistée par Muse ; le propriétaire a relu les faits et les huit traductions. Il ne s’agit pas d’une révision indépendante par un modèle. Cet article a été rédigé avec l'assistance de l'IA et n'a pas été vérifié de façon indépendante. Les chiffres et les descriptions de fonctionnalités sont les notes de version du projet vLLM sauf mention contraire ; les explications tierces sont citées séparément.
Ce qui est sorti
vLLM a publié la version 0.32.0 le 18 octobre 2026 : 814 commits de 363 contributeurs, dont 121 nouveaux dans le projet, selon les notes de version. La nouveauté phare est un endpoint de décisions structurées, POST /v1/systemone, qui répond aux questions choice, booléennes et de scoring sur un état structuré sans entrer dans la boucle de décodage autorégressive standard.
Le reste se lit comme un changelog pour opérateurs d'infrastructure : cache KV NVFP4 sur plus d'architectures GPU, cache KV FP8 par défaut sur GLM-5.x, Model Runner V2 par défaut sur ROCm, démarrage et service plus rapides, et une section sécurité dominée par un changement de CORS par défaut qui surprendra quiconque sert vLLM directement au navigateur.
L'endpoint /v1/systemone
L'interface est petite : vous envoyez un prompt plus un schéma de type choice avec une liste d'options, et le serveur renvoie la décision. Les notes de version l'activent par défaut et précisent qu'il fonctionne aussi sur clef-omni de Cloudflare, d1-3B de LiquidAI et DiffusionGemma — des petits modèles, exactement ceux qu'on choisirait pour un routeur de contrôle.
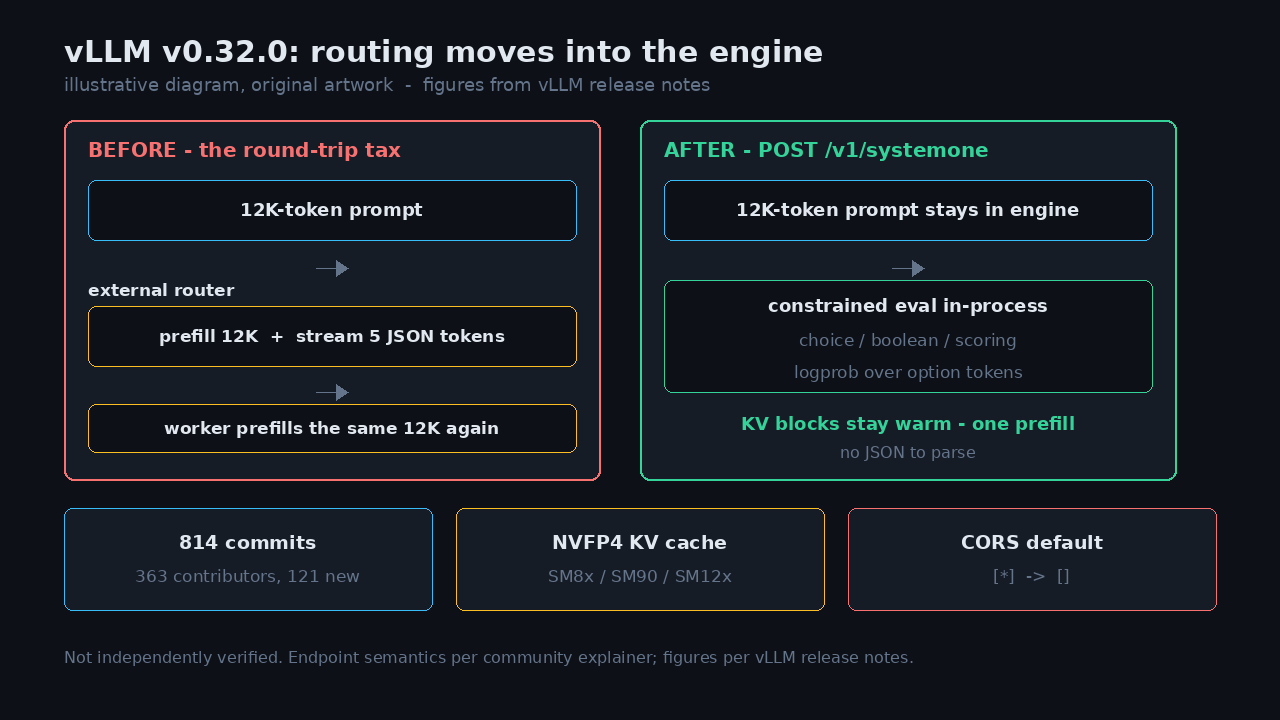
L'intéressant, c'est ce que le moteur ne fait pas. Pas de boucle de décodage autorégressive, pas de cinq tokens de JSON à parser, pas de tokens brouillons du décodage spéculatif. La décision est évaluée dans le processus du moteur, sur un état dont les blocs KV sont déjà chauds. C'est tout le pari : le routage cesse d'être un aller-retour et devient une évaluation sur place.
La taxe de l'aller-retour
Imaginez la boucle de triage typique d'un agent. Un prompt de 12 000 tokens arrive : instructions système, contexte de l'espace de travail, sorties récentes d'outils, la dernière requête utilisateur. Avant d'y consacrer un modèle 70B, vous voulez une décision de routage bon marché : faut-il exécuter un shell ?, est-ce sûr ?, quel schéma d'outils monter ?
La réponse standard a été un appel de routage séparé : prefill des mêmes 12 000 tokens sur un petit modèle, streaming de cinq tokens de JSON, parsing, puis la vraie requête — et un nouveau prefill de ces 12 000 tokens si le cache de préfixes a été évincé ou si le worker a changé. Vous payez la taxe de prefill deux fois pour une question booléenne, puis vous construisez des couches Redis et du routage fixe pour empêcher votre propre pile de se battre contre elle-même.
Déplacer la décision dans le moteur répond à cette douleur précise. Si le routeur évalue là où vivent les blocs KV, le préfixe reste épinglé dans les blocs PagedAttention et l'appel suivant peut toucher le cache de préfixes au lieu de recalculer l'attention. Combien vous économisez dépend de votre trafic — mais la taxe qu'il supprime est réelle.
Le cache KV basse précision partout
Le deuxième thème, c'est la densité mémoire. Le cache KV NVFP4 tourne désormais sur SM8x, SM90 et SM12x (avec décodage XQA sur SM12x), et GLM-5.x utilise par défaut un cache KV FP8 sur SM100, qui selon les notes divise par deux la mémoire KV par rank avec 2,3–5,5 % de débit en plus pour 7–11 % de TTFT en plus dans le benchmark du PR. Sur ROCm, un cache ultraquant 4 bits promet environ le double de la densité du FP8.
Ce sont les benchmarks propres du projet, pas des mesures indépendantes, et le marché est toujours le même : moins de mémoire par token contre un risque qualité ou latence à mesurer sur votre propre charge. Mais la direction est sans ambiguïté : la ressource rare du serving, c'est la mémoire KV, et chaque version consacre plus d'efforts à la compresser.
La mine de la mise à jour : CORS
Le changement le plus susceptible de vous réveiller n'est pas une fonctionnalité. vLLM 0.32 fait passer la valeur par défaut de --allowed-origins de ["*"] à [] : les navigateurs ne laisseront plus n'importe quel site appeler votre serveur de modèles par défaut. Le changement a atterri le 11 octobre et est entré dans la 0.32 via les release candidates ; la 0.31 — et toutes les versions jusqu'à la 0.6 — répondent encore Access-Control-Allow-Origin: *.
Si une page web d'une autre origine parle directement à votre serveur vLLM — une UI de chat interne, un playground sur un autre port, un frontend de notebook — la mise à jour la cassera jusqu'à ce que vous listiez les origines exactes. Les clients serveur ne sont pas affectés : curl, les SDK et les passerelles ne font pas de CORS. Dans tous les cas, lancez le contrôle preflight contre chacun de vos endpoints avant de mettre à jour, et gardez la clé API.
Ce que cela signifie pour votre pile
Pour les bâtisseurs d'agents, le signal porte sur l'endroit où doit vivre la logique du framework. La frontière entre serveur d'inférence et framework d'agents était autrefois nette : le serveur streamait des octets, le framework gérait les retries, le parsing d'outils et les machines à états. vLLM absorbe désormais les parties du framework qui touchent l'état chaud du moteur : parsing des blocs de raisonnement, parsing des tool calls, et maintenant les décisions de routage.
Les réserves honnêtes restent valables. L'histoire du mécanisme — échantillonnage contraint sur les tokens d'options, scoring par logprob, rétention du cache — vient d'un article communautaire, pas des notes de version, et les notes elles-mêmes écrivent le type de question intermédiaire « noul ». Considérez la sémantique comme directionnellement correcte jusqu'à lecture du PR.
Côté opérations : si un navigateur parle à vLLM, configurez vos origines avant la mise à jour, pas après. Si votre routeur d'agents est aujourd'hui un saut HTTP séparé, mesurez la fréquence à laquelle son préfixe survit jusqu'à l'appel suivant : ce nombre est ce que /v1/systemone veut éliminer. Et comme toujours, vérifiez les chiffres de débit du fournisseur sur votre propre trafic avant de redimensionner quoi que ce soit.
Sources et lectures
Le propriétaire a relu les références ; aucune vérification indépendante des faits ni révision indépendante par un modèle n’est revendiquée.
- notes de version du projet vLLM (GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- actualités IA quotidiennes d'olud.ai
olud.ai
Recorded publication date ·
Recorded verification time ·
- blog technique de Reid Marlow
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- article de DEV Community sur CORS
DEV Community
Recorded publication date ·
Recorded verification time ·