
AI 基础设施
vLLM v0.32.0 把 agent 路由搬进了推理引擎
推理引擎不再只是哑 token 泵:路由决策在进程内求值,复用已预热的 KV 块,不再为一次布尔判断付两次 prefill 税。10 月 18 日到底发布了什么、你的部署要改什么,一文说清。
Muse 辅助起草;事实与八语译文均由所有者审阅。这不是独立模型复审。 本文由 AI 辅助撰写,未经独立复审。数据与功能描述除特别标注外均引自 vLLM 项目官方发布说明;第三方解读另行引用。
发布了什么
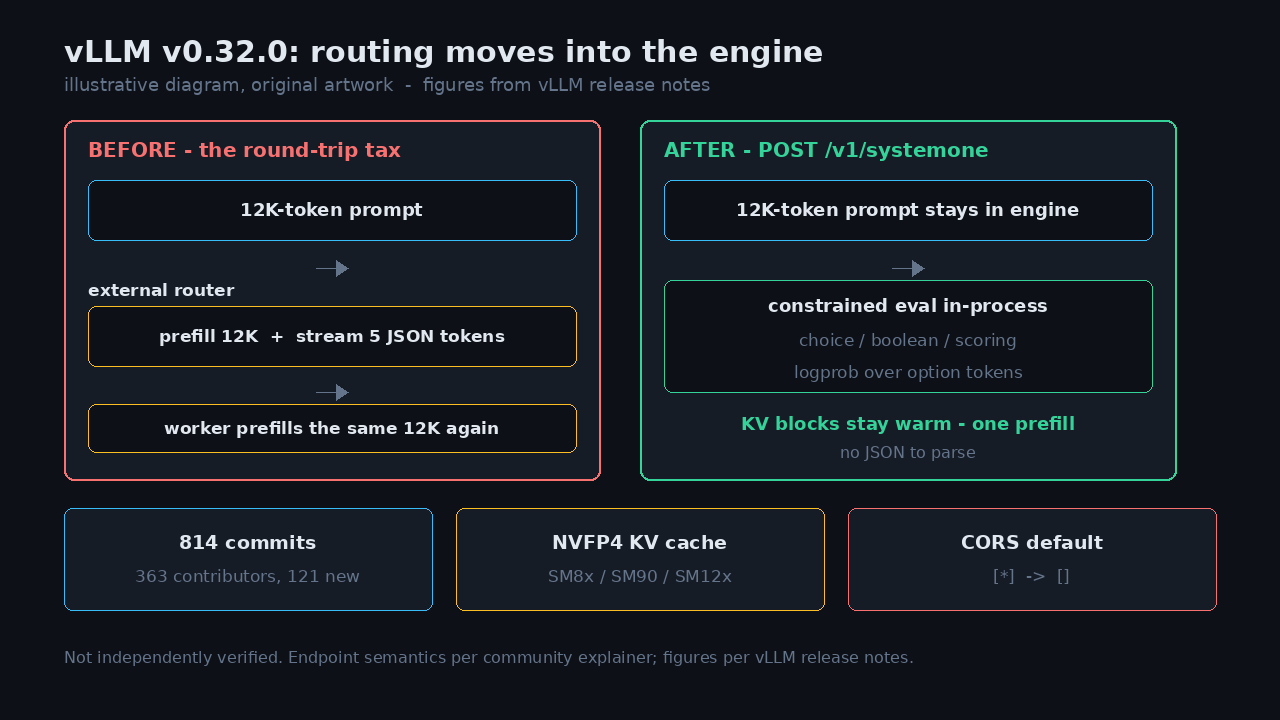
2026 年 10 月 18 日,vLLM 发布 v0.32.0:据项目发布说明,本版共 814 个 commit、363 位贡献者,其中 121 人是首次参与。头条功能是一个新的结构化决策接口 POST /v1/systemone,可以直接对结构化状态裁决 choice、boolean、scoring 三类问题,而不进入标准的自回归解码循环。
其余内容像一份写给基础设施运维的变更日志:更多 GPU 架构支持 NVFP4 KV 缓存、GLM-5.x 默认 FP8 KV 缓存、ROCm 上默认启用 Model Runner V2、更快的启动与服务,以及安全部分最醒目的一条——CORS 默认收紧,凡是让浏览器直连 vLLM 的部署,升级后都会中招。
/v1/systemone 接口
接口很小:发一个 prompt,加一个 type 为 choice、带候选列表的 schema,服务器直接返回裁决结果。发布说明称该接口默认启用,并已在 Cloudflare 的 clef-omni、LiquidAI 的 d1-3B 和 DiffusionGemma 上验证——都是小模型,正是你会选来做门控路由的那类。
有意思的是引擎没做什么:没有自回归解码循环,不会吐出 5 个 token 的 JSON 等你去解析,也不走推测解码的草稿 token。裁决在引擎进程内完成,用的正是 KV 块已经预热的那份状态。整个赌注就一句话:路由不再是一次往返,而是一次就地求值。
往返税
想象标准的 agent 分诊循环:一个 12000 token 的 prompt 落下来——系统指令、工作区上下文、最近的工具输出、用户最新请求。在动用 70B 模型之前,你想要一个廉价的路由决策:这需要执行 shell 吗?在当前容器里安全吗?下一轮该挂载哪个工具 schema?
标准答案一直是单独调一次路由:把同样的 12000 token 在小模型上再 prefill 一遍,流式吐 5 个 token 的 JSON,解析,然后发起真正的请求——如果前缀缓存被逐出或 worker 换了,那 12000 token 还要再 prefill 一次。为一个布尔问题付两次 prefill 税,然后你再去搭 Redis 层、做粘性路由,阻止自己的技术栈左右互搏。
把决策搬进引擎,正是对这种痛的回应。如果路由在 KV 块所在的位置求值,前缀就一直钉在 PagedAttention 块里,后续调用可以直接命中前缀缓存,而不必重算注意力。到底能省多少,取决于你的流量形态——但它消掉的这笔税是真实存在的。
低精度 KV 缓存全面铺开
第二个主题是显存密度。NVFP4 KV 缓存现已支持 SM8x、SM90、SM12x(SM12x 上带 XQA 解码);GLM-5.x 在 SM100 上默认 FP8 KV 缓存,按发布说明可将每 rank 的 KV 显存减半,代价是 PR 基准中 2.3–5.5% 的吞吐提升伴随 7–11% 的首 token 延迟(TTFT)增加。ROCm 上新增 4-bit ultraquant 缓存,密度约为 FP8 的两倍。
这些都是项目方自己的基准数据,未经独立测量,交易本质永远一样:用 token 级的显存换你要在自己负载上实测的质量或延迟风险。但方向毫不含糊——推理服务最稀缺的资源是 KV 显存,每一版都在花更大力气压缩它。
升级的地雷:CORS
最可能把人半夜叫醒的改动,根本不是功能。vLLM 0.32 把 --allowed-origins 默认值从 ["*"] 改成 []:浏览器默认不再允许任意网站调用你的模型服务器。这条改动 10 月 11 日落地,随 rc 版本进入 0.32;0.31 及回溯到 0.6 的所有版本,默认仍返回 Access-Control-Allow-Origin: *。
如果有跨源网页直连你的 vLLM 服务器——内网聊天 UI、另一个端口的 playground、notebook 前端——升级后会直接挂掉,直到你把确切的源列出来。服务端调用方不受影响:curl、SDK、网关都不走 CORS。无论如何,升级前先对你名下每个端点做一次 preflight 检查,并保持 API key 开启。
20 秒无声动画:旧路由模式下 12000 token 的 prompt 被 prefill 两次,随后 /v1/systemone 在引擎内裁决,最后滚动展示本版其他亮点。
对你的技术栈意味着什么
对 agent 构建者,信号在于框架逻辑该放在哪里。推理服务器和 agent 框架的边界曾经泾渭分明:服务器吐字节流,框架管重试、工具解析和状态机。现在 vLLM 正在把框架里碰热引擎状态的部分吸进去:推理块解析、工具调用解析,以及现在的路由决策。
诚实的保留意见依然适用:机制层面的解读——对候选 token 做受约束采样、用 logprob 打分、缓存保留——来自一篇社区解读文章,而非发布说明;发布说明本身把中间那类问题写成了 noul。在你读过 PR 之前,把这些语义当作方向正确即可。
操作层面:如果你的 vLLM 面向浏览器,趁升级前先把 origins 配好,别等挂了再配。如果你的 agent 路由今天还是独立的一次 HTTP 跳,先量一下它的前缀在后续调用里存活的比例——这个数字,就是 /v1/systemone 想要消掉的那笔账。最后照例:厂商的吞吐数字,先在你自己的流量上验证,再动容量规划。
资料来源与延伸阅读
来源记录由所有者审阅;不声称已完成独立事实核验或独立模型复审。
- vLLM 项目发布说明(GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- olud.ai 每日 AI 新闻
olud.ai
Recorded publication date ·
Recorded verification time ·
- Reid Marlow 技术博客
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- DEV Community CORS 撰文
DEV Community
Recorded publication date ·
Recorded verification time ·