
Инфраструктура ИИ
vLLM v0.32.0 переносит маршрутизацию агентов внутрь инференс-движка
Инференс-движок перестаёт быть глупым насосом токенов: решения о маршрутизации вычисляются в процессе, переиспользуя тёплые KV-блоки, вместо двойной оплаты налога на префилл. Что вышло 18 октября и что менять в вашем деплое.
Текст подготовлен с помощью Muse; владелец проверил факты и все восемь переводов. Это не независимая проверка моделью. Статья написана при помощи ИИ и не проходила независимую проверку. Цифры и описания функций — из официальных release notes проекта vLLM, если не указано иное; сторонние объяснения цитируются отдельно.
Что вышло
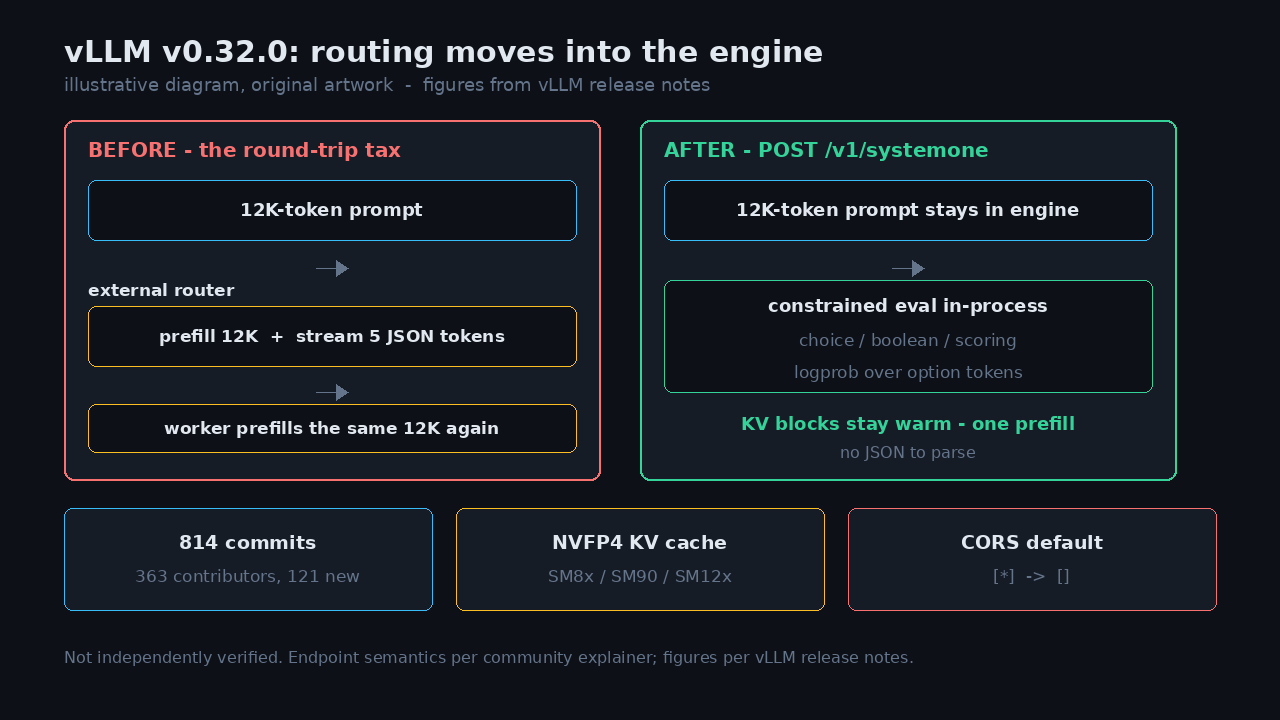
18 октября 2026 года vLLM выпустил версию 0.32.0: 814 коммитов от 363 контрибьюторов, 121 из них — новые участники проекта, согласно release notes. Главная новинка — эндпоинт структурированных решений POST /v1/systemone, отвечающий на вопросы choice, boolean и scoring поверх структурированного состояния без входа в стандартный цикл авторегрессивного декодирования.
Остальное читается как changelog для операторов инфраструктуры: NVFP4 KV-кэш на большем числе GPU-архитектур, FP8 KV-кэш по умолчанию для GLM-5.x, Model Runner V2 по умолчанию на ROCm, более быстрый старт и обслуживание, а в разделе безопасности — изменение CORS по умолчанию, которое станет сюрпризом для всех, кто отдаёт vLLM напрямую в браузер.
Эндпоинт /v1/systemone
Интерфейс компактный: отправляете промпт плюс схему типа choice со списком вариантов — сервер возвращает решение. В release notes он включён по умолчанию и отмечено, что он также работает на Cloudflare clef-omni, LiquidAI d1-3B и DiffusionGemma — маленьких моделях, ровно тех, что выбирают для гейтящего роутера.
Интересно то, чего движок не делает. Нет цикла авторегрессивного декодирования, нет пяти токенов JSON на разбор, нет черновых токенов спекулятивного декодирования. Решение вычисляется в процессе движка поверх состояния, чьи KV-блоки уже тёплые. В этом вся ставка: маршрутизация перестаёт быть круговым рейсом и становится вычислением на месте.
Налог на круговой рейс
Представьте типовой цикл сортировки агента. Прилетает промпт на 12 000 токенов: системные инструкции, контекст рабочей области, свежие выводы инструментов, последний запрос пользователя. Прежде чем тратить на него 70B-модель, хочется дешёвого решения о маршрутизации: нужен ли shell, безопасно ли это, какую схему инструментов подключить?
Стандартный ответ — отдельный вызов роутера: префилл тех же 12 000 токенов на маленькой модели, стрим пяти токенов JSON, разбор, затем настоящий запрос — и повторный префилл тех же 12 000 токенов, если префиксный кэш вытеснили или сменился воркер. За один булев вопрос вы дважды платите налог на префилл, а потом строите слои Redis и sticky-маршрутизацию, чтобы собственный стек перестал воевать сам с собой.
Перенос решения внутрь движка — ответ именно на эту боль. Если роутер вычисляет там, где живут KV-блоки, префикс остаётся закреплённым в блоках PagedAttention, и следующий вызов попадёт в префиксный кэш вместо пересчёта attention. Сколько вы сэкономите — зависит от вашего трафика, но налог, который он убирает, реален.
Низкоточный KV-кэш повсюду
Вторая тема — плотность памяти. NVFP4 KV-кэш теперь работает на SM8x, SM90 и SM12x (с XQA-декодированием на SM12x), а GLM-5.x по умолчанию использует FP8 KV-кэш на SM100, который, по данным notes, вдвое снижает KV-память на rank при росте пропускной способности на 2,3–5,5% ценой 7–11% TTFT в бенчмарке PR. На ROCm 4-битный ultraquant-кэш обещает примерно вдвое большую плотность, чем FP8.
Это собственные бенчмарки проекта, а не независимые измерения, и сделка всегда одна: меньше памяти на токен в обмен на риск качества или задержки, который нужно измерить на собственной нагрузке. Но направление недвусмысленно: дефицитный ресурс в сервинге — KV-память, и каждый релиз тратит всё больше усилий на её сжатие.
Мина обновления: CORS
Изменение, которое с наибольшей вероятностью поднимет вас ночью, — вовсе не фича. vLLM 0.32 меняет значение --allowed-origins по умолчанию с ["*"] на []: браузеры больше не позволят любому сайту по умолчанию вызывать ваш модельный сервер. Изменение приземлилось 11 октября и попало в 0.32 через релиз-кандидаты, так что 0.31 — и все версии вплоть до 0.6 — по-прежнему отвечают Access-Control-Allow-Origin: *.
Если веб-страница с другого origin напрямую обращается к вашему серверу vLLM — внутренний чат-UI, песочница на другом порту, фронтенд ноутбука — обновление сломает её, пока вы не перечислите точные origin'ы. Серверных клиентов это не касается: curl, SDK и шлюзы CORS не делают. В любом случае перед обновлением прогоните preflight-проверку по каждому своему эндпоинту и не отключайте API-ключ.
Что это значит для вашего стека
Для строителей агентов сигнал — о том, где должна жить логика фреймворка. Граница между инференс-сервером и агентным фреймворком раньше была чистой: сервер стримил байты, фреймворк занимался ретраями, разбором инструментов и конечными автоматами. vLLM теперь поглощает те части фреймворка, что касаются горячего состояния движка: разбор блоков рассуждений, разбор tool-call'ов, а теперь и решения о маршрутизации.
Честные оговорки остаются в силе. История механизма — ограниченный сэмплинг по токенам вариантов, скоринг по logprob, удержание кэша — из статьи сообщества, а не из release notes, а сами notes пишут средний тип вопроса как «noul». Считайте семантику верной по направлению, пока не прочитаете PR.
По операционке: если какой-то браузер разговаривает с vLLM, задайте origin'ы до обновления, а не после. Если ваш агентный роутер сегодня — отдельный HTTP-хоп, замерьте, как часто его префикс доживает до следующего вызова: это число — то, что /v1/systemone призван обнулить. И как всегда: цифры пропускной способности вендора проверяйте на собственном трафике, прежде чем что-то ресайзить.
Источники и дополнительные материалы
Владелец проверил записи источников; независимая проверка фактов или моделью не заявляется.
- release notes проекта vLLM (GitHub)
vLLM project (GitHub release notes)
Recorded publication date ·
Recorded verification time ·
- ежедневные новости ИИ от olud.ai
olud.ai
Recorded publication date ·
Recorded verification time ·
- технический блог Рида Марлоу
Reid Marlow (personal technical blog)
Recorded publication date ·
Recorded verification time ·
- разбор CORS от DEV Community
DEV Community
Recorded publication date ·
Recorded verification time ·