

البنية التحتية للذكاء الاصطناعي
رهان إنتل D270: الاستدلال في الذكاء الاصطناعي مشكلة ذاكرة لا سرعة
في قمة المشروع الحوسبي المفتوح، حوّلت إنتل مشروع Crescent Island الذي طال انتظاره إلى خط إنتاج — وجادلت بأن ما يهم في الذكاء الاصطناعي الوكيلي هو مقدار الذاكرة التي تتسع على البطاقة أكثر من سرعة كل بايت.
صياغة بمساعدة Muse؛ راجع المالك الحقائق والترجمات الثماني. هذه ليست مراجعة مستقلة بواسطة نموذج. كُتب هذا المقال بمساعدة الذكاء الاصطناعي ولم يخضع لمراجعة مستقلة. الأرقام هي المواصفات المنشورة من إنتل وتقديرات طرف ثالث موسومة بوضوح؛ لا توجد اختبارات مستقلة بعد.
ما الذي حدث؟
في 12 أكتوبر 2026، خلال قمة المشروع الحوسبي المفتوح في سان خوسيه، أطلقت إنتل اسمًا تجاريًا حقيقيًا على مسرّع الاستدلال الذي طال انتظاره وكان يُعرف باسم Crescent Island: سلسلة Intel GPU D-series، ويقودها الطراز الأول GPU D270. وتضمّن الإعلان الرسمي أيضًا تصاميم جديدة لرفوف Xeon 6+ ودفعة برمجية مفتوحة لما تسميه إنتل عصر الذكاء الاصطناعي الوكيلي.
الأرقام الرئيسية تتحدث عن الذاكرة لا عن السرعة الخام: حتى 480 غيغابايت من ذاكرة LPDDR5X، وعرض نطاق 1.5 تيرابايت/ثانية، و1.3 بيتافلوب من حوسبة FP8، كل ذلك داخل بطاقة PCIe مبردة بالهواء بقدرة 350 واط. وكان الشعار الذي ردده مسؤولو إنتل: «ضع كل موجّه في مكانه» — أي مطابقة كل عبء ذكاء اصطناعي مع أرخص عتاد ينجزه بكفاءة.
المواصفات والمقايضة
D270 هي أول شريحة بمعمارية Xe3P من إنتل. وتشير التقارير التقنية إلى 32 نواة Xe3P و256 محرك مصفوفات XMX — وهي الوحدات التي تنفذ عمليات المصفوفات في الشبكات العصبية — مع إزالة دوائر الرسوميات وتتبع الأشعة لإفساح مساحة الحوسبة. البطاقة بمنفذ PCIe قياسي وتبريد هوائي سلبي، فتنزلق في مراكز البيانات القائمة دون حلقات تبريد سائل أو رفوف خاصة.
تأتي الذاكرة بمستويين والفرق مهم. بطاقة إنتل نفسها تحمل 160 غيغابايت من LPDDR5X؛ بينما يتيح التصميم لشركاء الخوادم بناء بطاقات بمرونة تصل إلى 480 غيغابايت. وتقول إنتل إن البطاقة الواحدة تستضيف نماذج حتى نحو 300 مليار معامل، وأن نظامًا من ثماني بطاقات يتجاوز تريليون معامل.
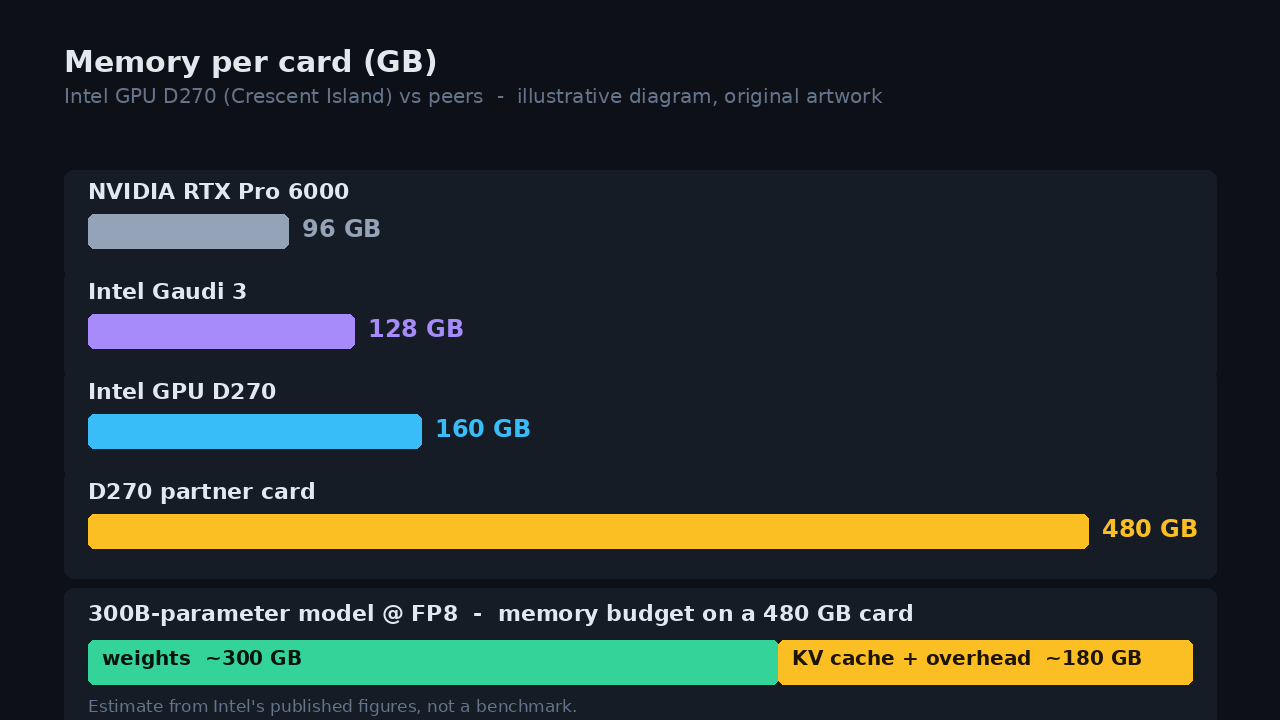
المقايضة معلنة: LPDDR5X أرخص بكثير للغيغابايت وأسهل شراءً وأكفأ في الطاقة من ذاكرة HBM المكدسة في شرائح الذكاء الاصطناعي الرائدة — لكنها أبطأ بكثير. فبطاقة Gaudi 3 من إنتل نفسها تحمل 128 غيغابايت من HBM2e بعرض 3.7 تيرابايت/ثانية، وبطاقة RTX Pro 6000 من نفيديا تجمع 96 غيغابايت من GDDR7 مع نحو 1.8 تيرابايت/ثانية. وتوفر D270 حتى خمسة أضعاف ذاكرة RTX Pro 6000 بعرض نطاق مماثل. إنتل تراهن على أن السعة لكل واط — ولكل دولار — هي الرقم المهم لخدمة الاستدلال الكثيف التفكيك، قبل ذروة عرض النطاق.
لماذا الوكلاء نهمون للذاكرة؟
يبدأ منطق إنتل من طبيعة عمل الوكلاء فعليًا. فوكيل البرمجة أو البحث يحتفظ بسجل طويل في السياق — غالبًا 100 ألف رمز أو أكثر — ويستدعي النموذج مرارًا عبر آلاف الخطوات. كل استدعاء يبدأ بالتهيئة حيث يعالج النموذج كامل الموجّه، ثم ينتقل إلى التفكيك لتوليد الإجابة رمزًا فرمزًا. وكل هذا السياق يعيش في ذاكرة KV، وهي ذاكرة النموذج لكل رمز سبق رؤيته، وتنمو مع طول السياق وعدد المستخدمين المتزامنين.
حسابات الذاكرة هي ما يجعل رقم 480 غيغابايت ملموسًا. بدقة FP8 يشغل كل معامل بايتًا واحدًا تقريبًا، فنموذج كثيف من 300 مليار معامل يحتاج نحو 300 غيغابايت للأوزان فقط — تاركًا نحو 180 غيغابايت لذاكرة KV والسياقات الأطول والحمل التشغيلي على بطاقة 480 غيغابايت. والحد الصادق يعمل بالاتجاه الآخر أيضًا: أثناء التفكيك يجب قراءة كل الأوزان النشطة مرة لكل رمز، فبعرض 1.5 تيرابايت/ثانية يُحصر تدفق واحد من نموذج كثيف 300B عند نحو خمسة رموز في الثانية. هذه تقديرات من أرقام إنتل المنشورة لا اختبارات؛ فالنشر الحقيقي يجمّع المستخدمين ومعظم النماذج الكبيرة تستخدم معمارية خليط الخبراء حيث لا ينشط إلا جزء من المعاملات لكل رمز.
هذه هي الرهان كله في جملة واحدة: في حصة متزايدة من أعمال الاستدلال، مقدار ما يتسع على البطاقة أهم من سرعة كل بايت. وعندما لا تتسع الذاكرة، يضطر المزود لتوزيع العمل على بطاقات أكثر أو التخلص من السياق — والوكلاء، بطول سياقاتهم واستدعاءاتهم المتكررة، هم أول من يصطدم بهذا الجدار.
من البطاقة إلى الرف: نظرة المنظومة
لم يكن D270 الخبر الوحيد من إنتل. فقد عرضت الشركة تصاميم رفوف Xeon 6+، كثير منها بمعيار Open Rack v3، وتتجاوز التكوينات الأكثف 46 ألف نواة معالج للرف الواحد بقدرة 133.45 كيلوواط. وحجة إنتل أن الوكلاء يقومون بقدر كبير من العمل ليس استدلالًا نمذجيًا أصلًا: توجيه الطلبات وتشغيل الأدوات وتنفيذ الشيفرة والبحث في قواعد البيانات ونقل البيانات.
ومن هنا يأتي السطر الأكثر إثارة في البيان: مع تطور بنية الذكاء الاصطناعي، يُقاس الأداء أكثر فأكثر بعدد الوكلاء المتزامنين الذين يستطيع الرف sustaining عند زمن استجابة مستهدف. وسلطت إنتل الضوء أيضًا على عملها في مجموعة Open Adapter Card ضمن OCP — مع AMD وDell ونفيديا وكوالكوم — لتوحيد معيار بطاقات المسرّعات دون الرف الكامل.
على صعيد البرمجيات، تعتمد إنتل على أساس Xe مشترك مع بقية معالجاتها الرسومية، وتعد بتكامل أصلي مع vLLM ومنظومة PyTorch، ودعم من اليوم صفر للنماذج المفتوحة الجديدة بدءًا من نموذج Muse Glimmer من ميتا (30 مليار معامل). أما مجموعة أدوات Enterprise Agent Toolkit فتعمل على معالجات Xeon اليوم؛ ودعم معالجات الرسوميات مخطط له لا متاح بعد — وهو التحفظ البرمجي الذي يجب مراقبته.
ما الذي ما زلنا لا نعرفه؟
الفجوات كبيرة وإنتل لا تخفيها تمامًا — لكنها لم تملأها ببساطة. لا يوجد سعر، وهو الأهم لبطاقة تبيع نفسها بتكلفة الغيغابايت والرمز. وأخذ العينات جارٍ لدى صناع الخوادم ومزودي السحابة وشركات البرمجيات، لكن لا يوجد موعد إتاحة عام. ولا توجد أرقام رموز/ثانية منشورة لنماذج محددة ولا اختبارات مستقلة؛ فلا أحد خارج إنتل وعملاء العينات جرّب البطاقة.
ورقم 480 غيغابايت الرئيسي يعتمد على قرار الشركاء ببناء تلك البطاقات — فبطاقة إنتل نفسها 160 غيغابايت. وسجل إنتل السابق في معالجات مراكز البيانات، من Ponte Vecchio إلى Gaudi، عانى في انتزاع حصة من نفيديا، ولهذا تهم شريحة الشركاء ذات الـ53 شعارًا وعمل تعريفات لينكس بقدر ما تهم ورقة المواصفات.
ماذا يعني ذلك؟
بالنسبة لكثير من الشركات، فاتورة تشغيل الذكاء الاصطناعي باتت أهم من فاتورة تدريبه، والوكلاء يضخّمون الفاتورة بسياقاتهم الطويلة واستدعاءاتهم المتكررة. بطاقة أرخص مبردة بالهواء بذاكرة كبيرة قد تتيح للشركات والسحب الحكومية والمزودين الأصغر تشغيل نماذج مفتوحة كبيرة على عتاد يمكن شراؤه وتشغيله فعليًا — دون تقسيمها على بطاقات باهظة كثيرة.
ولمنظومة النماذج المفتوحة، بطاقة واحدة تستوعب نموذج 300 مليار معامل تجعل النشر الخاص أسهل ماديًا: نماذج قوية مفتوحة الأوزان تعمل محليًا تحت سيطرة مالكها، وهو أمر جيد لسيادة البيانات والمنافسة في سوق تضع فيه إمدادات HBM وأسعار نفيديا القواعد للجميع تقريبًا.
التشخيص صحيح — الوكلاء نهمون للذاكرة وHBM هو أغلى مكونات عتاد الذكاء الاصطناعي وأكثرها تقييدًا بالإمداد. لكن دون سعر ودون أرقام رموز مستقلة، ومع اعتماد خيار 480 غيغابايت على الشركاء، يبقى D270 شريحة عرض قوية لا منتجًا مثبتًا. إن حددت إنتل سعرًا منافسًا وكان دعم vLLM متينًا من اليوم الأول، فقد تكون هذه أول بطاقة ذكاء اصطناعي من إنتل يرغب المشترون فيها فعلًا. وستكون الاختبارات المستقلة هي الحكم.
المصادر وقراءات إضافية
راجع المالك سجلات المصادر؛ ولا يُدّعى إجراء تحقق مستقل من الحقائق أو مراجعة مستقلة بواسطة نموذج.
- البيان الصحفي الرسمي لإنتل
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- التحليل التقني من djcroman
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·