

Infraestructura de IA
El D270 de Intel apuesta a que la inferencia de IA es un problema de memoria, no de velocidad
En la Cumbre Global del OCP, Intel convirtió su largamente anticipado proyecto Crescent Island en una línea de productos, y argumentó que para la IA agéntica importa más cuánta memoria cabe en una tarjeta que la velocidad de cada byte.
Redacción asistida por Muse; el propietario revisó los hechos y las ocho traducciones. No es una revisión independiente por un modelo. Este artículo fue escrito con asistencia de IA y no ha sido revisado de forma independiente. Las cifras son especificaciones publicadas por Intel y estimaciones de terceros claramente etiquetadas; aún no existen benchmarks independientes.
Qué pasó
El 12 de octubre de 2026, en la Cumbre Global del Open Compute Project en San José, Intel dio un nombre comercial real a su largamente anticipado acelerador de inferencia, de nombre en clave Crescent Island: la serie Intel GPU D, liderada por el primer modelo, la GPU D270. El anuncio, recogido en un comunicado oficial de Intel, presentó también nuevos diseños de racks Xeon 6+ y una ofensiva de software abierto para lo que Intel llama la era de la IA agéntica.
Las cifras destacadas hablan deliberadamente de memoria y no de velocidad bruta: hasta 480 GB de memoria LPDDR5X, 1,5 TB/s de ancho de banda y 1,3 petaflops de cómputo FP8, todo en una tarjeta PCIe de 350 vatios refrigerada por aire. La frase recurrente de los ejecutivos fue «put every prompt in its place»: asignar cada carga de IA al hardware más barato que la resuelva bien.
Las especificaciones y el compromiso
La D270 es el primer chip con la arquitectura Xe3P de Intel. La cobertura técnica detalla 32 núcleos Xe3P y 256 motores matriciales XMX —las unidades que ejecutan la matemática matricial de las redes neuronales—, con los circuitos de gráficos y trazado de rayos eliminados para dar espacio al cómputo. La tarjeta usa un factor de forma PCIe estándar y refrigeración pasiva por aire, así que encaja en los centros de datos existentes, sin circuitos de refrigeración líquida ni racks especiales.
La memoria llega en dos niveles, y la distinción importa. La tarjeta de marca Intel trae 160 GB de LPDDR5X; el diseño permite a los socios fabricar sus propias tarjetas con configuraciones flexibles de hasta 480 GB. Según Intel, una sola tarjeta puede alojar modelos de hasta unos 300.000 millones de parámetros, y un sistema de ocho tarjetas supera el billón de parámetros.
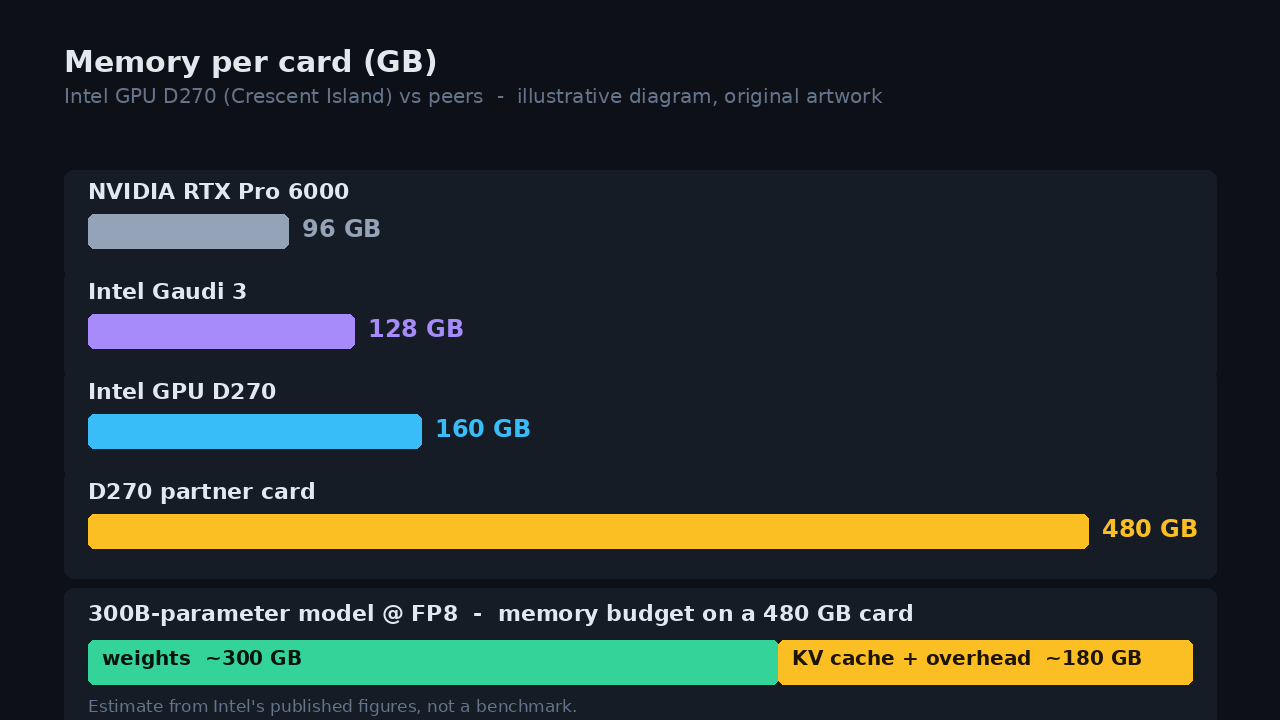
El compromiso es explícito: la LPDDR5X es mucho más barata por gigabyte, más fácil de conseguir y mucho más eficiente energéticamente que la HBM apilada de los chips insignia de IA, pero también mucho más lenta. Gaudi 3, la actual tarjeta de inferencia de Intel, lleva 128 GB de HBM2e a 3,7 TB/s; la RTX Pro 6000 de Nvidia combina 96 GB de GDDR7 con unos 1,8 TB/s. La D270 ofrece hasta cinco veces la memoria de la RTX Pro 6000 con un ancho de banda comparable. Intel posiciona la capacidad por vatio —y por dólar— como la cifra relevante para el serving con decodificación intensiva, por delante del pico de ancho de banda.
Por qué los agentes devoran memoria
La lógica del producto de Intel parte de lo que los agentes hacen realmente. Un agente de programación o investigación mantiene un largo historial en contexto —a menudo 100.000 tokens o más— y llama al modelo una y otra vez durante miles de pasos. Cada llamada empieza con el prefill, donde el modelo procesa todo el prompt, y pasa al decode, generando la respuesta token por token. Todo ese contexto vive en la caché KV, la memoria del modelo sobre cada token ya visto, y la caché crece con la longitud del contexto y el número de usuarios simultáneos.
La aritmética de la memoria es lo que hace concreta la cifra de 480 GB. En precisión FP8 cada parámetro ocupa aproximadamente un byte, así que un modelo denso de 300.000 millones de parámetros necesita unos 300 GB solo para sus pesos, dejando unos 180 GB para la caché KV, contextos más largos y sobrecarga en una tarjeta de 480 GB. El límite honesto funciona también al revés: durante el decode, un modelo denso debe leer todos sus pesos activos una vez por token, así que a 1,5 TB/s un único flujo de un modelo denso de 300B queda limitado a unos cinco tokens por segundo. Son estimaciones a partir de las cifras publicadas por Intel, no benchmarks; los despliegues reales agrupan muchos usuarios y la mayoría de los modelos grandes usan diseños de mezcla de expertos donde solo una fracción de los parámetros está activa por token.
Esa es toda la apuesta en una frase: para una porción creciente del trabajo de inferencia, importa más cuánto cabe en una tarjeta que la velocidad de cada byte. Cuando la caché ya no cabe, el proveedor debe repartir el trabajo entre más tarjetas o descartar contexto, o ambas cosas, y los agentes, con sus contextos largos y llamadas repetidas, chocan primero con ese muro.
De la tarjeta al rack: la visión de sistema
La D270 no fue el único anuncio de Intel. La compañía mostró diseños de racks Xeon 6+, muchos bajo el estándar OCP Open Rack v3, con configuraciones densas que superan los 46.000 núcleos de CPU por rack a 133,45 kW de potencia total. El argumento de Intel es que los agentes hacen una gran cantidad de trabajo que no es inferencia del modelo: enrutar solicitudes, ejecutar herramientas, correr código, buscar en bases de datos, mover datos.
De ahí la frase más interesante del comunicado: a medida que evoluciona la infraestructura de IA, el rendimiento se mide cada vez más por el número de agentes concurrentes que un rack puede sostener con una latencia objetivo. Intel destacó también su trabajo en el grupo Open Adapter Card del OCP —junto a AMD, Dell, Nvidia y Qualcomm— para estandarizar un factor de forma de tarjeta aceleradora intermedio entre una PCIe simple y un rack completo.
En software, Intel se apoya en una base Xe común con sus otras GPU, promete integración nativa con vLLM y el ecosistema PyTorch, y anuncia soporte desde el día cero para nuevos modelos abiertos, empezando por Muse Glimmer de Meta, de 30.000 millones de parámetros. Su AI for Enterprise Agent Toolkit funciona hoy en procesadores Xeon; el soporte para GPU está planeado pero aún no disponible: la advertencia de software a vigilar.
Lo que aún no sabemos
Las lagunas son grandes e Intel no las oculta exactamente, simplemente no las ha llenado. No hay precio, y es lo que más importa para una tarjeta que se vende por coste por gigabyte y por token. El muestreo a clientes está en marcha con fabricantes de servidores, proveedores de nube y empresas de software, pero no hay fecha de disponibilidad general. No hay cifras publicadas de tokens por segundo para modelos concretos ni benchmarks independientes; nadie fuera de Intel y sus clientes de muestreo ha probado la tarjeta.
Y el titular de 480 GB depende de que los socios decidan fabricar esas tarjetas: la tarjeta de Intel trae 160 GB. Los anteriores esfuerzos de Intel en GPU para centros de datos, de Ponte Vecchio a Gaudi, lucharon por ganar cuota frente a Nvidia, por eso la diapositiva del ecosistema con 53 logotipos de socios y el trabajo de controladores Linux importan tanto como la hoja de especificaciones.
Qué significa
Para muchas empresas, la factura de ejecutar la IA ya importa más que la de entrenarla, y los agentes la inflan con sus contextos largos y llamadas repetidas al modelo. Una tarjeta más barata, refrigerada por aire y con mucha memoria podría permitir a empresas, nubes gubernamentales y proveedores pequeños ejecutar grandes modelos abiertos en hardware que realmente pueden comprar y alimentar, sin repartirlos entre muchas GPU caras.
Para el ecosistema de modelos abiertos, una sola tarjeta capaz de contener un modelo de 300.000 millones de parámetros facilita materialmente el despliegue privado: modelos potentes de pesos abiertos corriendo en local, bajo el control de su dueño, lo cual es bueno para la soberanía de datos y la competencia en un mercado donde el suministro de HBM y los precios de Nvidia fijan las reglas para casi todos.
El diagnóstico es correcto: los agentes devoran memoria y la HBM es la parte más cara y con suministro más limitado del stack de hardware de IA. Pero sin precio, sin cifras independientes de tokens y con la opción de 480 GB en manos de los socios, la D270 sigue siendo una gran diapositiva más que un producto probado. Si Intel logra un precio competitivo y el soporte de vLLM es sólido desde el día uno, esta podría ser la primera tarjeta de IA de Intel que los compradores realmente quieran. Los benchmarks independientes dictarán el veredicto.
Fuentes y lecturas
El propietario revisó los registros de fuentes; no se afirma una verificación independiente de hechos ni una revisión independiente por un modelo.
- comunicado oficial de Intel
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- análisis técnico de djcroman
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·