

AI 基础设施
英特尔 D270:当 AI 推理变成一道显存题
在 OCP 全球峰会上,英特尔把长期预热的 Crescent Island 项目变成了一条产品线——并提出:对智能体 AI 而言,一张卡能装下多少显存,比每个字节跑多快更重要。
Muse 辅助起草;事实与八语译文均由所有者审阅。这不是独立模型复审。 本文由 AI 辅助撰写,未经独立审查。数字为英特尔已发布规格及明确标注的第三方估算;目前尚无独立实测。
发生了什么
2026 年 10 月 12 日,在圣何塞举行的开放计算项目(OCP)全球峰会上,英特尔给长期预热、代号 Crescent Island 的推理加速器起了一个正式产品名:Intel GPU D 系列,首款型号为 GPU D270。这份官方新闻稿同时发布了新的 Xeon 6+ 机架设计,以及面向英特尔所称“智能体 AI 时代”的开放软件布局。
标题数字刻意谈显存而非绝对速度:最高 480GB LPDDR5X 显存、1.5TB/s 显存带宽、1.3 petaflops FP8 算力,全部装进一张 350 瓦风冷 PCIe 卡。高管们反复强调的一句话是“put every prompt in its place”——给每个 AI 负载匹配能胜任的最便宜硬件。
规格,以及取舍
D270 是英特尔 Xe3P 架构的首款芯片。据技术报道,它集成 32 个 Xe3P 核心和 256 个 XMX 矩阵引擎——执行神经网络矩阵运算的单元,去掉了图形与光追电路,把芯片面积让给算力。标准 PCIe 形态、被动风冷,可直接插进现有数据中心,无需液冷回路或专用机架。
显存分两档,这个区别很关键。英特尔自有品牌卡为 160GB LPDDR5X;设计允许服务器合作伙伴自建弹性配置、最高 480GB 的卡。英特尔称单卡可承载约 3000 亿参数模型,八卡系统可扩展到超过 1 万亿参数。
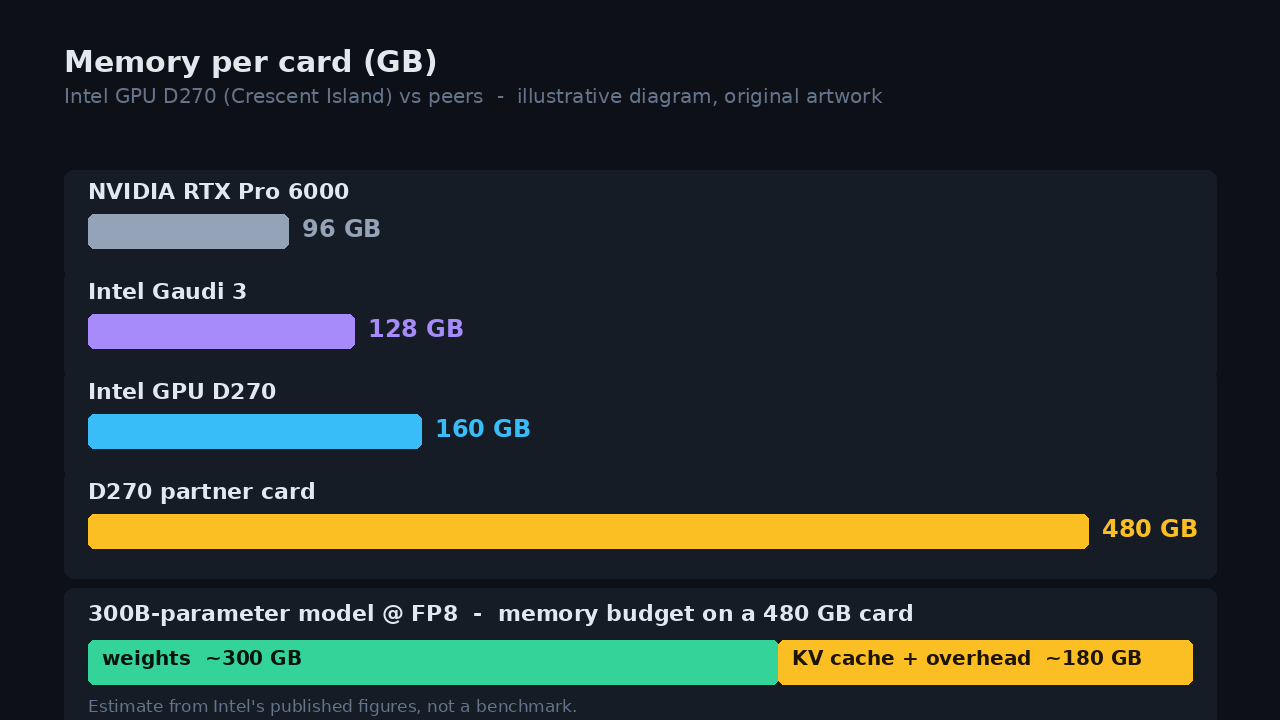
取舍是明确的:LPDDR5X 每 GB 便宜得多、好买得多、能效高得多,但比旗舰 AI 芯片用的堆叠式 HBM 慢得多。英特尔自家现款推理卡 Gaudi 3 是 128GB HBM2e、3.7TB/s;英伟达 RTX Pro 6000 是 96GB GDDR7、约 1.8TB/s。D270 的显存最高可达 RTX Pro 6000 的五倍,带宽却在同一量级。英特尔正在把“每瓦容量——以及每美元容量”塑造成解码密集型服务的关键指标,排在峰值带宽之前。
为什么智能体是显存黑洞
英特尔的产品逻辑从智能体的真实行为出发。编程或研究智能体会在上下文里保留很长的历史——常常 10 万 token 以上,并在数千步里反复调用模型。每次调用先做 prefill(模型处理整个 prompt),再进入 decode(逐 token 生成答案)。所有上下文都住在 KV 缓存里——模型对每个已见 token 的记忆,缓存随上下文长度和并发用户数一起膨胀。
显存算术让 480GB 这个数字变得具体。FP8 精度下每个参数约占 1 字节,稠密的 3000 亿参数模型光权重就要约 300GB,在 480GB 卡上还剩约 180GB 给 KV 缓存、更长上下文和运行开销。诚实的上限反过来也成立:decode 时稠密模型每个 token 要把全部活跃权重读一遍,以 1.5TB/s 计算,单路 300B 稠密模型的上限约为每秒 5 个 token。这些是根据英特尔已发布数字的估算,不是跑分;真实部署会把众多用户批量处理,而且多数大模型采用 MoE 架构,每个 token 只有一部分参数被激活。
20 秒动画:四张推理卡的显存容量条形生长,随后带宽条形展示容量与速度的取舍,最后一个 300B 参数模型的显存预算填满一张 480GB 卡。
整个赌注一句话概括:在越来越多的推理 workload 里,一张卡能装多少,比每个字节跑多快更重要。缓存装不下时,服务商只能把任务摊到更多卡上,或丢弃上下文,或两者兼有——而上下文长、调用频繁的智能体,会最先撞上这堵墙。
从卡到机架:系统视角
D270 不是英特尔唯一的发布。公司还展示了 Xeon 6+ 机架设计,多采用 OCP Open Rack v3 标准,最密配置单机架超过 46000 个 CPU 核心,总功耗 133.45kW。英特尔的论点是:智能体有大量工作根本不是模型推理——路由请求、跑工具、执行代码、查数据库、搬数据。
于是有了新闻稿里最有意思的一句:随着 AI 基础设施演进,性能越来越多地用“单机架在目标延迟下能撑住多少并发智能体”来衡量。英特尔还强调了它在 OCP Open Adapter Card 工作组的进展——与 AMD、戴尔、英伟达、高通一起,为介于普通 PCIe 卡和整机架之间的加速卡形态制定标准。
软件上,英特尔依托与其他 GPU 通用的 Xe 软件栈,承诺与 vLLM 和 PyTorch 生态做原生上游集成,并对新开放模型提供“day-zero”支持,首个例子是 Meta 300 亿参数的 Muse Glimmer。它的企业智能体工具包(AI for Enterprise Agent Toolkit)今天跑在 Xeon 上;GPU 支持在规划中、尚未落地——这是要盯的软件变量。
还不知道什么
未知项很多,英特尔倒也不算藏着——只是还没填上。没有价格,而这对一张靠“每 GB / 每 token 成本”卖自己的卡恰恰最重要。面向服务器厂商、云厂商和软件公司的客户送样已经开始,但没有正式上市日期。没有针对具体模型的每秒 token 数,没有独立跑分;英特尔和送样客户之外,没人测过这张卡。
而且 480GB 的标题数字取决于合作伙伴愿不愿意造这种卡——英特尔自己的卡是 160GB。从 Ponte Vecchio 到 Gaudi,英特尔此前的数据中心 GPU 在英伟达面前都没抢到份额,所以那张 53 个合作伙伴 logo 的生态幻灯片和 Linux 上游驱动工作,和规格表一样重要。
意味着什么
对很多公司来说,跑 AI 的账单现在比训练 AI 的账单更重要,而智能体用超长上下文和反复调用把账单越撑越大。一张更便宜、风冷、大显存的卡,能让企业、政务云和中小服务商在真正买得起、供得上电的硬件上跑大开放模型——不用把模型切碎摊到一堆昂贵的 GPU 上。
对开放模型生态,单卡装下 3000 亿参数模型让私有化部署实质性变容易:强大的开放权重模型在本地跑、在自己手里,这对数据主权和竞争都是好事——在一个 HBM 供给和英伟达定价给几乎所有人定规矩的市场里。
诊断是对的——智能体是显存黑洞,HBM 是 AI 硬件栈里最贵、供给最紧的一环。但没有价格、没有独立 token 数据、480GB 选项捏在合作伙伴手里,D270 目前还是一张漂亮的幻灯片,而非被验证过的产品。如果英特尔开出有竞争力的价格、vLLM 支持在首日就绪,这可能成为第一张买家真正想要的英特尔 AI 卡。独立跑分会给出裁决。
资料来源与延伸阅读
来源记录由所有者审阅;不声称已完成独立事实核验或独立模型复审。
- 英特尔官方新闻稿
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- djcroman 技术解析
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·