

KI-Infrastruktur
Intels D270 wettet darauf, dass KI-Inferenz ein Speicherproblem ist, kein Geschwindigkeitsproblem
Auf dem OCP Global Summit hat Intel aus dem lange angeteaserten Project Crescent Island eine Produktlinie gemacht – und argumentiert, dass für agentische KI zählt, wie viel Speicher auf eine Karte passt, nicht wie schnell sich jedes Byte bewegt.
Entwurf mit Unterstützung von Muse; der Eigentümer hat die Fakten und alle acht Übersetzungen geprüft. Dies ist keine unabhängige Modellprüfung. Dieser Artikel wurde mit KI-Unterstützung geschrieben und nicht unabhängig geprüft. Zahlen sind Intels veröffentlichte Spezifikationen sowie klar gekennzeichnete Schätzungen Dritter; unabhängige Benchmarks gibt es noch nicht.
Was passiert ist
Am 12. Oktober 2026 hat Intel auf dem Open Compute Project Global Summit in San Jose seinem lange angeteaserten Inferenz-Beschleuniger mit dem Codenamen Crescent Island einen echten Produktnamen gegeben: die Intel GPU D-Serie, angeführt vom ersten Modell GPU D270. Die offizielle Pressemitteilung stellte außerdem neue Xeon-6+-Rack-Designs und eine offene Software-Offensive für das vor, was Intel die Ära der agentischen KI nennt.
Die Schlagzeilen handeln bewusst von Speicher statt von roher Geschwindigkeit: bis zu 480 GB LPDDR5X, 1,5 TB/s Speicherbandbreite und 1,3 Petaflops FP8-Rechenleistung – in einer 350-Watt-luftgekühlten PCIe-Karte. Die wiederholte Botschaft der Intel-Führungskräfte lautete „put every prompt in its place“ – jede KI-Arbeitslast auf die günstigste Hardware, die sie gut bewältigt.
Die Spezifikationen und der Kompromiss
Die D270 ist der erste Chip auf Intels Xe3P-Architektur. Die Fachberichterstattung nennt 32 Xe3P-Kerne und 256 XMX-Matrix-Engines – die Einheiten für die Matrix-Mathematik neuronaler Netze – wobei Grafik- und Raytracing-Schaltungen zugunsten von Rechenfläche entfernt wurden. Die Karte nutzt einen Standard-PCIe-Formfaktor und passive Luftkühlung und passt damit in bereits existierende Rechenzentren, ohne Flüssigkühlung oder Spezial-Racks.
Der Speicher kommt in zwei Stufen, und die Unterscheidung zählt. Intels eigene Karte liefert 160 GB LPDDR5X; das Design erlaubt Serverpartnern eigene Karten mit flexiblen Konfigurationen bis 480 GB. Laut Intel hostet eine Karte Modelle bis etwa 300 Milliarden Parameter, ein Acht-Karten-System skaliert über eine Billion Parameter hinaus.
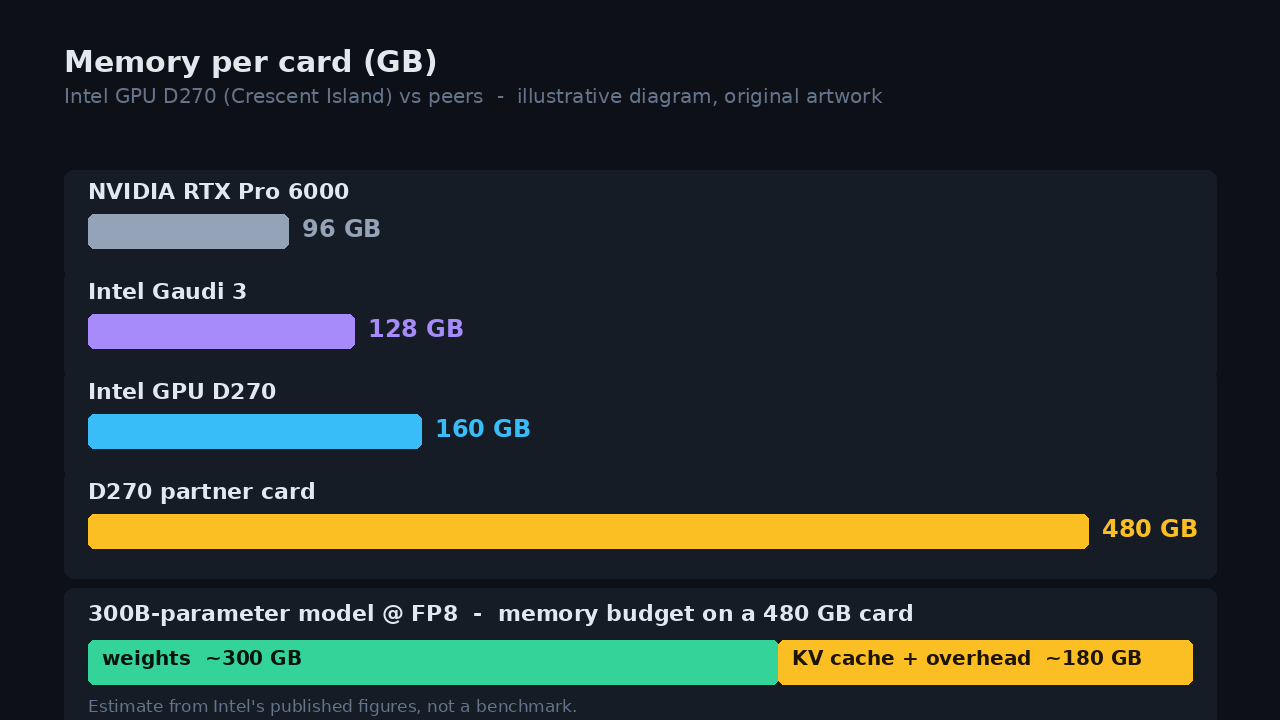
Der Kompromiss ist explizit: LPDDR5X ist pro Gigabyte weit billiger, leichter zu beschaffen und deutlich energieeffizienter als das gestapelte HBM der Flaggschiff-KI-Chips – aber auch viel langsamer. Gaudi 3, Intels aktuelle Inferenzkarte, trägt 128 GB HBM2e mit 3,7 TB/s; Nvidias RTX Pro 6000 kombiniert 96 GB GDDR7 mit rund 1,8 TB/s. Die D270 bietet bis zum Fünffachen des Speichers der RTX Pro 6000 bei vergleichbarer Bandbreite. Intel positioniert Kapazität pro Watt – und pro Dollar – als die Kennzahl für decode-lastiges Serving, vor Spitzenbandbreite.
Warum Agenten speicherhungrig sind
Intels Produktlogik beginnt damit, was Agenten tatsächlich tun. Ein Coding- oder Research-Agent hält eine lange Historie im Kontext – oft 100.000 Tokens oder mehr – und ruft das Modell über Tausende von Schritten immer wieder auf. Jeder Aufruf beginnt mit Prefill, der Verarbeitung des gesamten Prompts, und geht dann in Decode über, die tokenweise Generierung der Antwort. All dieser Kontext lebt im KV-Cache, dem Gedächtnis des Modells für jedes bereits gesehene Token, und der Cache wächst mit Kontextlänge und der Zahl gleichzeitig bedienter Nutzer.
Die Speicherrechnung macht die 480 GB greifbar. In FP8 belegt jeder Parameter grob ein Byte, also braucht ein dichtes 300-Milliarden-Parameter-Modell etwa 300 GB allein für die Gewichte – bleiben rund 180 GB für KV-Cache, längere Kontexte und Laufzeit-Overhead auf einer 480-GB-Karte. Die ehrliche Grenze wirkt auch umgekehrt: Beim Decodieren muss ein dichtes Modell alle aktiven Gewichte einmal pro Token lesen, sodass bei 1,5 TB/s ein einzelner Stream eines dichten 300B-Modells bei rund fünf Tokens pro Sekunde gedeckelt ist. Das sind Schätzungen aus Intels veröffentlichten Zahlen, keine Benchmarks; reale Deployments bündeln viele Nutzer, und die meisten großen Modelle nutzen Mixture-of-Experts, bei der pro Token nur ein Bruchteil der Parameter aktiv ist.
Das ist die ganze Wette in einem Satz: Für einen wachsenden Anteil der Inferenzarbeit zählt, wie viel auf eine Karte passt, mehr als wie schnell sich jedes Byte bewegt. Passt der Cache nicht mehr, muss ein Anbieter die Arbeit auf mehr Karten verteilen oder Kontext verwerfen – und Agenten mit ihren langen Kontexten und wiederholten Aufrufen stoßen zuerst an diese Wand.
Von der Karte zum Rack: die Systemperspektive
Die D270 war nicht Intels einzige Ankündigung. Das Unternehmen zeigte Xeon-6+-Rack-Designs, viele nach dem OCP-Standard Open Rack v3, deren dichteste Konfigurationen über 46.000 CPU-Kerne pro Rack bei 133,45 kW Gesamtleistung skalieren. Intels Argument: Agenten leisten viel Arbeit, die gar keine Modellinferenz ist – Anfragen routen, Tools ausführen, Code laufen lassen, Datenbanken durchsuchen, Daten bewegen.
Daraus folgt die interessanteste Zeile der Pressemitteilung: Mit der Entwicklung der KI-Infrastruktur bemisst sich Leistung zunehmend an der Zahl gleichzeitiger Agenten, die ein Rack bei Ziellatenz durchhält. Intel hob zudem seine Arbeit in der OCP-Arbeitsgruppe Open Adapter Card hervor – gemeinsam mit AMD, Dell, Nvidia und Qualcomm –, um einen standardisierten Sub-Rack-Formfaktor für Beschleunigerkarten zu definieren.
Softwareseitig setzt Intel auf ein gemeinsames Xe-Fundament wie bei seinen anderen GPUs, verspricht native Upstream-Integration mit vLLM und dem PyTorch-Ökosystem sowie Day-Zero-Support für neue offene Modelle, beginnend mit Metas 30-Milliarden-Parameter-Modell Muse Glimmer. Sein AI for Enterprise Agent Toolkit läuft heute auf Xeon-Prozessoren; GPU-Support ist geplant, aber noch nicht verfügbar – der Software-Vorbehalt, den man beobachten sollte.
Was wir noch nicht wissen
Die Lücken sind groß, und Intel versteckt sie nicht unbedingt – es hat sie nur schlicht nicht gefüllt. Es gibt keinen Preis, und der zählt am meisten für eine Karte, die sich über Kosten pro Gigabyte und pro Token verkauft. Das Customer Sampling läuft bei Serverherstellern, Cloud-Anbietern und Softwarefirmen, aber es gibt kein Datum für die allgemeine Verfügbarkeit. Es gibt keine veröffentlichten Tokens-pro-Sekunde-Werte für konkrete Modelle und keine unabhängigen Benchmarks; niemand außerhalb von Intel und seiner Sampling-Kunden hat die Karte getestet.
Und die 480-GB-Schlagzeile hängt davon ab, dass Partner sich entscheiden, solche Karten zu bauen – Intels eigene Karte hat 160 GB. Intels frühere Rechenzentrums-GPU-Versuche von Ponte Vecchio bis Gaudi taten sich schwer, gegen Nvidia Anteile zu gewinnen; deshalb zählen die Ecosystem-Folie mit 53 Partnerlogos und die Upstream-Linux-Treiberarbeit so viel wie das Datenblatt.
Was das bedeutet
Für viele Unternehmen zählt die Rechnung für den Betrieb von KI inzwischen mehr als die Rechnung fürs Training, und Agenten blähen sie auf – mit langen Kontexten und wiederholten Modellaufrufen. Eine billigere, luftgekühlte Karte mit viel Speicher könnte Unternehmen, Regierungs-Clouds und kleineren Anbietern erlauben, große offene Modelle auf Hardware zu betreiben, die sie tatsächlich kaufen und mit Strom versorgen können – ohne sie über viele teure GPUs zu verteilen.
Für das Open-Model-Ökosystem macht eine Karte, die ein 300-Milliarden-Parameter-Modell allein fasst, privates Deployment materiell einfacher: starke offene Modelle laufen lokal, unter eigener Kontrolle – gut für Datensouveränität und Wettbewerb in einem Markt, in dem HBM-Angebot und Nvidia-Preise für fast alle die Regeln setzen.
Die Diagnose stimmt – Agenten sind speicherhungrig, und HBM ist der teuerste und am stärksten angebotsbeschränkte Teil des KI-Hardware-Stacks. Aber ohne Preis, ohne unabhängige Token-Zahlen und mit der 480-GB-Option in Partnerhand bleibt die D270 eine starke Folie statt eines bewiesenen Produkts. Landet Intel einen wettbewerbsfähigen Preis und steht der vLLM-Support am ersten Tag solide, könnte dies die erste Intel-KI-Karte sein, die Käufer wirklich wollen. Die unabhängigen Benchmarks werden das Urteil fällen.
Quellen und weitere Lektüre
Der Eigentümer hat die Quellenangaben geprüft; eine unabhängige Fakten- oder Modellprüfung wird nicht behauptet.
- Offizielle Intel-Pressemitteilung
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- Technische Analyse von djcroman
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·