

Infrastructure IA
Le D270 d'Intel parie que l'inférence IA est un problème de mémoire, pas de vitesse
Lors du Sommet mondial de l'OCP, Intel a transformé son projet Crescent Island, longtemps teasé, en une gamme de produits — et soutient que pour l'IA agentique, ce qui compte c'est la quantité de mémoire sur une carte, pas la vitesse de chaque octet.
Rédaction assistée par Muse ; le propriétaire a relu les faits et les huit traductions. Il ne s’agit pas d’une révision indépendante par un modèle. Cet article a été rédigé avec l'assistance de l'IA et n'a pas été vérifié de façon indépendante. Les chiffres sont les spécifications publiées par Intel et des estimations tierces clairement étiquetées ; aucun benchmark indépendant n'existe encore.
Ce qui s'est passé
Le 12 octobre 2026, lors du Sommet mondial de l'Open Compute Project à San Jose, Intel a donné un vrai nom produit à son accélérateur d'inférence longtemps teasé, nom de code Crescent Island : la gamme Intel GPU D-series, menée par le premier modèle, le GPU D270. L'annonce, relayée dans un communiqué officiel d'Intel, a aussi présenté de nouveaux designs de racks Xeon 6+ et une offensive logicielle ouverte pour ce qu'Intel appelle l'ère de l'IA agentique.
Les chiffres mis en avant parlent délibérément de mémoire plutôt que de vitesse brute : jusqu'à 480 Go de mémoire LPDDR5X, 1,5 To/s de bande passante mémoire et 1,3 pétaflops de calcul FP8, le tout dans une carte PCIe de 350 watts refroidie par air. La formule martelée par les dirigeants était « put every prompt in its place » — associer chaque charge IA au matériel le moins cher capable de bien la traiter.
Les spécifications, et le compromis
Le D270 est la première puce sur l'architecture Xe3P d'Intel. La couverture technique détaille 32 cœurs Xe3P et 256 moteurs matriciels XMX — les unités qui effectuent les calculs matriciels des réseaux de neurones — les circuits graphiques et de ray tracing ayant été supprimés pour laisser la place au calcul. La carte utilise un format PCIe standard et un refroidissement passif par air, et s'insère donc dans les centres de données existants, sans boucles de refroidissement liquide ni racks spéciaux.
La mémoire arrive en deux paliers, et la distinction compte. La carte de marque Intel embarque 160 Go de LPDDR5X ; le design permet aux partenaires serveurs de construire leurs propres cartes avec des configurations flexibles jusqu'à 480 Go. Selon Intel, une carte peut héberger des modèles jusqu'à environ 300 milliards de paramètres, et un système de huit cartes dépasse le billion de paramètres.
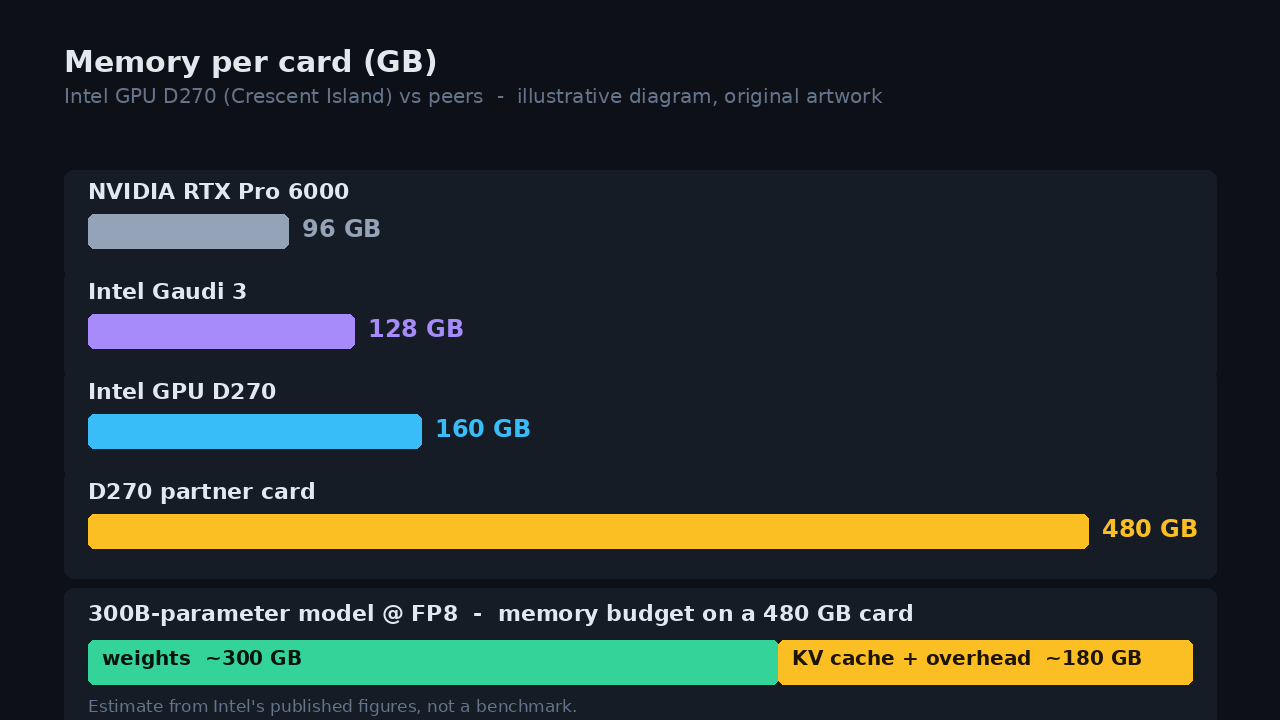
Le compromis est explicite : la LPDDR5X est bien moins chère au gigaoctet, plus facile à acheter et bien plus efficace énergétiquement que la HBM empilée des puces IA phares — mais elle est aussi bien plus lente. Gaudi 3, l'actuelle carte d'inférence d'Intel, embarque 128 Go de HBM2e à 3,7 To/s ; la RTX Pro 6000 de Nvidia associe 96 Go de GDDR7 à environ 1,8 To/s. Le D270 offre jusqu'à cinq fois la mémoire de la RTX Pro 6000 à un niveau de bande passante comparable. Intel positionne la capacité par watt — et par dollar — comme le chiffre qui compte pour le serving à décodage intensif, avant la bande passante crête.
Pourquoi les agents sont gourmands en mémoire
Le raisonnement produit d'Intel part de ce que les agents font réellement. Un agent de code ou de recherche garde un long historique en contexte — souvent 100 000 tokens ou plus — et appelle le modèle encore et encore sur des milliers d'étapes. Chaque appel commence par le prefill, où le modèle traite tout le prompt, puis passe au décodage, générant la réponse token par token. Tout ce contexte vit dans le cache KV, la mémoire du modèle pour chaque token déjà vu, et le cache grandit avec la longueur du contexte et le nombre d'utilisateurs servis simultanément.
Le calcul mémoire rend concret le chiffre de 480 Go. En précision FP8, chaque paramètre occupe environ un octet, donc un modèle dense de 300 milliards de paramètres a besoin d'environ 300 Go rien que pour ses poids — laissant environ 180 Go pour le cache KV, des contextes plus longs et la surcharge d'exécution sur une carte de 480 Go. La limite honnête joue aussi dans l'autre sens : pendant le décodage, un modèle dense doit lire tous ses poids actifs une fois par token, donc à 1,5 To/s un flux unique d'un modèle dense de 300B est plafonné à environ cinq tokens par seconde. Ce sont des estimations issues des chiffres publiés par Intel, pas des benchmarks ; les déploiements réels regroupent de nombreux utilisateurs et la plupart des grands modèles utilisent des architectures à mélange d'experts où seule une fraction des paramètres est active par token.
C'est tout le pari en une phrase : pour une part croissante du travail d'inférence, ce qui tient sur une carte compte plus que la vitesse de chaque octet. Quand le cache ne tient plus, un fournisseur doit répartir le travail sur plus de cartes, jeter du contexte, ou les deux — et les agents, avec leurs longs contextes et leurs appels répétés, heurtent ce mur en premier.
De la carte au rack : la vision système
Le D270 n'était pas la seule annonce d'Intel. L'entreprise a montré des designs de racks Xeon 6+, beaucoup au standard OCP Open Rack v3, dont les configurations les plus denses dépassent 46 000 cœurs CPU par rack pour 133,45 kW de puissance totale. L'argument d'Intel : les agents accomplissent énormément de travail qui n'est pas du tout de l'inférence de modèle — router les requêtes, exécuter des outils, faire tourner du code, interroger des bases de données, déplacer des données.
D'où la phrase la plus intéressante du communiqué : à mesure que l'infrastructure IA évolue, la performance se mesure de plus en plus au nombre d'agents simultanés qu'un rack peut soutenir à latence cible. Intel a aussi mis en avant son travail dans le groupe de travail OCP Open Adapter Card — formé avec AMD, Dell, Nvidia et Qualcomm — pour standardiser un format de carte accélératrice intermédiaire entre une simple carte PCIe et un rack complet.
Côté logiciel, Intel s'appuie sur une fondation Xe commune avec ses autres GPU, promet une intégration native en amont avec vLLM et l'écosystème PyTorch, et annonce un support dès le premier jour pour les nouveaux modèles ouverts, à commencer par Muse Glimmer de Meta à 30 milliards de paramètres. Son AI for Enterprise Agent Toolkit tourne aujourd'hui sur processeurs Xeon ; le support GPU est prévu mais pas encore disponible — la réserve logicielle à surveiller.
Ce que l'on ne sait pas encore
Les lacunes sont grandes et Intel ne les cache pas vraiment — il ne les a simplement pas comblées. Il n'y a pas de prix, et c'est ce qui compte le plus pour une carte qui se vend au coût par gigaoctet et par token. L'échantillonnage client est en cours chez les fabricants de serveurs, les fournisseurs de cloud et les éditeurs logiciels, mais il n'y a pas de date de disponibilité générale. Il n'y a pas de chiffres publiés de tokens par seconde pour des modèles précis ni de benchmarks indépendants ; personne en dehors d'Intel et de ses clients d'échantillonnage n'a testé la carte.
Et le titre des 480 Go dépend de la décision des partenaires de construire ces cartes — la carte d'Intel fait 160 Go. Les précédents efforts d'Intel en GPU pour centres de données, de Ponte Vecchio à Gaudi, ont peiné à gagner des parts face à Nvidia ; c'est pourquoi la diapositive d'écosystème aux 53 logos partenaires et le travail sur les pilotes Linux comptent autant que la fiche technique.
Ce que cela signifie
Pour beaucoup d'entreprises, la facture d'exploitation de l'IA compte désormais plus que la facture d'entraînement, et les agents la gonflent avec leurs longs contextes et leurs appels répétés au modèle. Une carte moins chère, refroidie par air et riche en mémoire pourrait permettre aux entreprises, aux clouds gouvernementaux et aux petits fournisseurs de faire tourner de grands modèles ouverts sur du matériel qu'ils peuvent réellement acheter et alimenter — sans les répartir sur de nombreuses GPU coûteuses.
Pour l'écosystème des modèles ouverts, une carte unique capable de contenir un modèle de 300 milliards de paramètres rend le déploiement privé matériellement plus simple : des modèles puissants à poids ouverts tournant en local, sous le contrôle de leur propriétaire — bon pour la souveraineté des données et la concurrence sur un marché où l'offre de HBM et les prix de Nvidia fixent les règles pour presque tout le monde.
Le diagnostic est juste — les agents sont gourmands en mémoire et la HBM est la partie la plus chère et la plus contrainte en approvisionnement du stack matériel IA. Mais sans prix, sans chiffres de tokens indépendants, et avec l'option 480 Go entre les mains des partenaires, le D270 reste une belle diapositive plutôt qu'un produit prouvé. Si Intel décroche un prix compétitif et que le support vLLM est solide dès le premier jour, ce pourrait être la première carte IA d'Intel que les acheteurs veulent vraiment. Les benchmarks indépendants trancheront.
Sources et lectures
Le propriétaire a relu les références ; aucune vérification indépendante des faits ni révision indépendante par un modèle n’est revendiquée.
- communiqué officiel d'Intel
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- analyse technique de djcroman
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·