

Infraestrutura de IA
O D270 da Intel aposta que a inferência de IA é um problema de memória, não de velocidade
Na Cúpula Global do OCP, a Intel transformou seu há muito aguardado projeto Crescent Island em uma linha de produtos — e argumentou que, para a IA agêntica, importa mais quanta memória cabe em uma placa do que a velocidade de cada byte.
Redação assistida por Muse; o proprietário revisou os fatos e as oito traduções. Não se trata de revisão independente por um modelo. Este artigo foi escrito com assistência de IA e não foi revisado de forma independente. Os números são especificações publicadas pela Intel e estimativas de terceiros claramente rotuladas; ainda não existem benchmarks independentes.
O que aconteceu
Em 12 de outubro de 2026, na Cúpula Global do Open Compute Project em San Jose, a Intel deu um nome comercial real ao seu há muito aguardado acelerador de inferência, de codinome Crescent Island: a série Intel GPU D, liderada pelo primeiro modelo, a GPU D270. O anúncio, veiculado em comunicado oficial da Intel, apresentou também novos designs de racks Xeon 6+ e uma ofensiva de software aberto para o que a Intel chama de era da IA agêntica.
Os números de destaque falam deliberadamente de memória, não de velocidade bruta: até 480 GB de memória LPDDR5X, 1,5 TB/s de largura de banda e 1,3 petaflops de computação FP8, tudo em uma placa PCIe de 350 watts refrigerada a ar. A frase repetida pelos executivos foi 'put every prompt in its place' — associar cada carga de IA ao hardware mais barato capaz de resolvê-la bem.
As especificações e o compromisso
A D270 é o primeiro chip na arquitetura Xe3P da Intel. A cobertura técnica detalha 32 núcleos Xe3P e 256 motores matriciais XMX — as unidades que executam a matemática matricial das redes neurais — com os circuitos de gráficos e ray tracing removidos para dar espaço à computação. A placa usa um formato PCIe padrão e refrigeração passiva a ar, encaixando-se nos data centers existentes, sem loops de refrigeração líquida nem racks especiais.
A memória chega em dois níveis, e a distinção importa. A placa da marca Intel traz 160 GB de LPDDR5X; o design permite que parceiros de servidores construam suas próprias placas com configurações flexíveis de até 480 GB. Segundo a Intel, uma única placa pode hospedar modelos de até cerca de 300 bilhões de parâmetros, e um sistema de oito placas supera um trilhão de parâmetros.
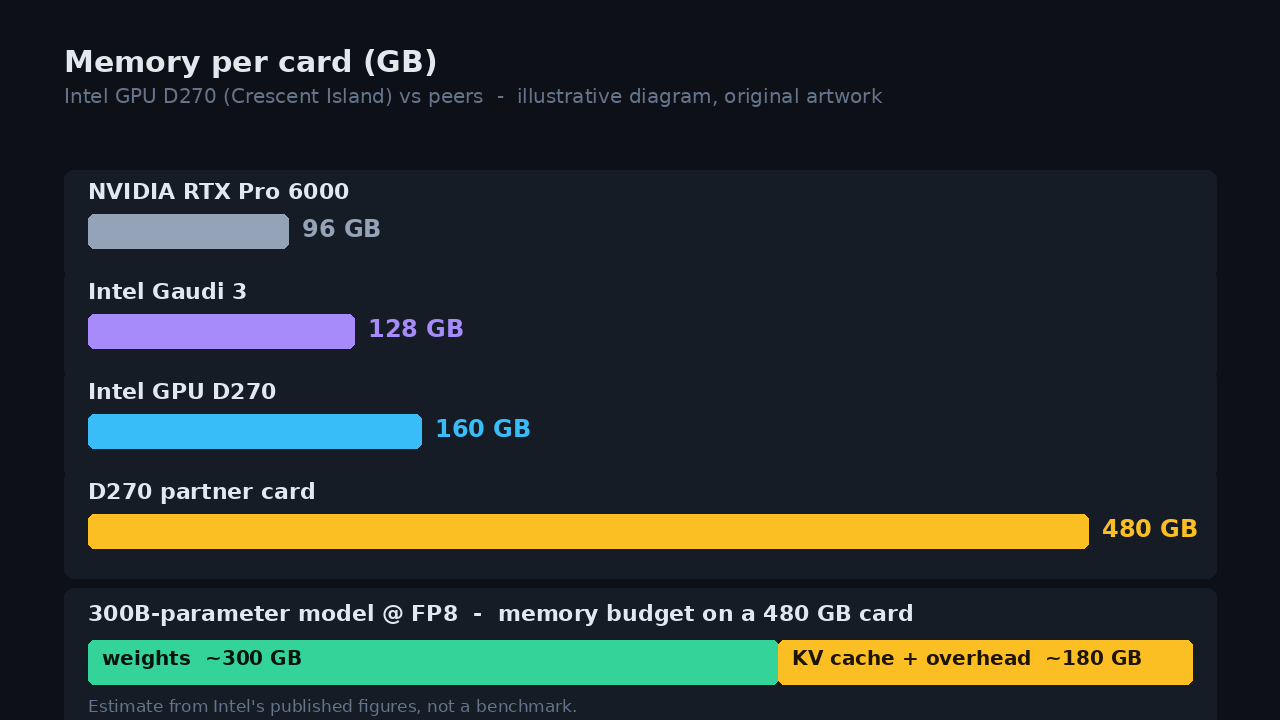
O compromisso é explícito: a LPDDR5X é muito mais barata por gigabyte, mais fácil de comprar e muito mais eficiente em energia do que a HBM empilhada dos chips de IA de ponta — mas também muito mais lenta. A Gaudi 3, atual placa de inferência da Intel, carrega 128 GB de HBM2e a 3,7 TB/s; a RTX Pro 6000 da Nvidia combina 96 GB de GDDR7 com cerca de 1,8 TB/s. A D270 oferece até cinco vezes a memória da RTX Pro 6000 com largura de banda comparável. A Intel posiciona a capacidade por watt — e por dólar — como o número relevante para serving com decodificação intensiva, à frente do pico de largura de banda.
Por que os agentes devoram memória
A lógica de produto da Intel parte do que os agentes realmente fazem. Um agente de programação ou pesquisa mantém um longo histórico em contexto — muitas vezes 100 mil tokens ou mais — e chama o modelo repetidamente ao longo de milhares de etapas. Cada chamada começa com o prefill, em que o modelo processa todo o prompt, e passa à decodificação, gerando a resposta token por token. Todo esse contexto vive no cache KV, a memória do modelo sobre cada token já visto, e o cache cresce com o comprimento do contexto e o número de usuários simultâneos.
A aritmética da memória é o que torna concreto o número de 480 GB. Em precisão FP8, cada parâmetro ocupa aproximadamente um byte, de modo que um modelo denso de 300 bilhões de parâmetros precisa de cerca de 300 GB apenas para seus pesos — restando cerca de 180 GB para o cache KV, contextos mais longos e sobrecarga em uma placa de 480 GB. O limite honesto funciona também ao contrário: durante a decodificação, um modelo denso precisa ler todos os seus pesos ativos uma vez por token, de modo que a 1,5 TB/s um único fluxo de um modelo denso de 300B fica limitado a cerca de cinco tokens por segundo. São estimativas a partir dos números publicados pela Intel, não benchmarks; implantações reais agrupam muitos usuários e a maioria dos grandes modelos usa arquiteturas de mistura de especialistas em que apenas uma fração dos parâmetros está ativa por token.
Essa é toda a aposta em uma frase: para uma parcela crescente do trabalho de inferência, importa mais o quanto cabe em uma placa do que a velocidade de cada byte. Quando o cache não cabe mais, o provedor precisa distribuir o trabalho por mais placas ou descartar contexto — ou ambos — e os agentes, com seus contextos longos e chamadas repetidas, batem primeiro nesse muro.
Da placa ao rack: a visão de sistema
A D270 não foi o único anúncio da Intel. A empresa mostrou designs de racks Xeon 6+, muitos no padrão OCP Open Rack v3, com as configurações mais densas superando 46 mil núcleos de CPU por rack a 133,45 kW de potência total. O argumento da Intel é que os agentes realizam uma grande quantidade de trabalho que nem é inferência do modelo: rotear solicitações, executar ferramentas, rodar código, buscar em bancos de dados, mover dados.
Daí a frase mais interessante do comunicado: à medida que a infraestrutura de IA evolui, o desempenho se mede cada vez mais pelo número de agentes simultâneos que um rack sustenta com latência-alvo. A Intel também destacou seu trabalho no grupo Open Adapter Card do OCP — formado com AMD, Dell, Nvidia e Qualcomm — para padronizar um formato intermediário de placa aceleradora entre uma PCIe simples e um rack completo.
Em software, a Intel se apoia em uma base Xe comum com suas outras GPUs, promete integração nativa com vLLM e o ecossistema PyTorch, e anuncia suporte desde o dia zero para novos modelos abertos, começando pelo Muse Glimmer da Meta, de 30 bilhões de parâmetros. Seu AI for Enterprise Agent Toolkit roda hoje em processadores Xeon; o suporte a GPU está planejado, mas ainda não disponível — a ressalva de software a observar.
O que ainda não sabemos
As lacunas são grandes e a Intel não as esconde exatamente — apenas não as preencheu. Não há preço, e é o que mais importa para uma placa que se vende pelo custo por gigabyte e por token. A amostragem a clientes está em andamento com fabricantes de servidores, provedores de nuvem e empresas de software, mas não há data de disponibilidade geral. Não há números publicados de tokens por segundo para modelos específicos nem benchmarks independentes; ninguém fora da Intel e de seus clientes de amostragem testou a placa.
E a manchete de 480 GB depende de os parceiros decidirem construir essas placas — a placa da Intel tem 160 GB. Os esforços anteriores da Intel em GPU para data centers, de Ponte Vecchio a Gaudi, lutaram para ganhar participação contra a Nvidia, por isso o slide de ecossistema com 53 logotipos de parceiros e o trabalho de drivers Linux importam tanto quanto a folha de especificações.
O que isso significa
Para muitas empresas, a conta de operar IA já importa mais do que a de treiná-la, e os agentes a inflam com seus contextos longos e chamadas repetidas ao modelo. Uma placa mais barata, refrigerada a ar e com muita memória poderia permitir que empresas, nuvens governamentais e provedores menores executem grandes modelos abertos em hardware que realmente podem comprar e alimentar — sem reparti-los por muitas GPUs caras.
Para o ecossistema de modelos abertos, uma única placa capaz de conter um modelo de 300 bilhões de parâmetros torna a implantação privada materialmente mais fácil: modelos potentes de pesos abertos rodando localmente, sob o controle de seu dono — bom para a soberania de dados e a concorrência em um mercado onde a oferta de HBM e os preços da Nvidia ditam as regras para quase todos.
O diagnóstico está correto — os agentes devoram memória e a HBM é a parte mais cara e com oferta mais limitada da pilha de hardware de IA. Mas sem preço, sem números independentes de tokens e com a opção de 480 GB nas mãos dos parceiros, a D270 segue sendo um ótimo slide mais do que um produto provado. Se a Intel acertar um preço competitivo e o suporte a vLLM for sólido desde o dia um, esta pode ser a primeira placa de IA da Intel que os compradores realmente queiram. Os benchmarks independentes darão o veredito.
Fontes e leituras
O proprietário revisou os registros de fontes; não se afirma verificação independente dos fatos nem revisão independente por um modelo.
- comunicado oficial da Intel
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- análise técnica do djcroman
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·