

Инфраструктура ИИ
Intel D270 ставит на то, что ИИ-инференс — это задача памяти, а не скорости
На саммите OCP Global Summit Intel превратила свой давно анонсированный проект Crescent Island в продуктовую линейку — и заявила, что для агентного ИИ важнее, сколько памяти помещается на карту, а не скорость каждого байта.
Текст подготовлен с помощью Muse; владелец проверил факты и все восемь переводов. Это не независимая проверка моделью. Статья написана при помощи ИИ и не проходила независимую проверку. Цифры — опубликованные спецификации Intel и чётко помеченные сторонние оценки; независимых бенчмарков пока нет.
Что произошло
12 октября 2026 года на саммите Open Compute Project Global Summit в Сан-Хосе Intel дала своему давно анонсированному ускорителю инференса под кодовым именем Crescent Island настоящее продуктовое имя: серия Intel GPU D, которую возглавляет первая модель GPU D270. Анонс, опубликованный в официальном пресс-релизе Intel, также представил новые стоечные решения Xeon 6+ и открытую программную инициативу для того, что Intel называет эрой агентного ИИ.
Заголовочные цифры намеренно говорят о памяти, а не о чистой скорости: до 480 ГБ памяти LPDDR5X, 1,5 ТБ/с пропускной способности памяти и 1,3 петафлопса вычислений FP8 — всё это в 350-ваттной карте PCIe с воздушным охлаждением. Рефреном руководителей звучала фраза «put every prompt in its place» — подобрать каждую ИИ-нагрузку под самое дешёвое железо, которое хорошо с ней справляется.
Характеристики и компромисс
D270 — первый чип на архитектуре Intel Xe3P. Техническая пресса детализирует: 32 ядра Xe3P и 256 матричных движков XMX — блоков, выполняющих матричную математику нейросетей, — при этом графические и трассировочные схемы убраны ради вычислительной площади. Карта использует стандартный форм-фактор PCIe и пассивное воздушное охлаждение, поэтому встаёт в уже существующие дата-центры без контуров жидкостного охлаждения и специальных стоек.
Память идёт в двух уровнях, и различие важно. Фирменная карта Intel несёт 160 ГБ LPDDR5X; дизайн позволяет серверным партнёрам выпускать собственные карты с гибкими конфигурациями до 480 ГБ. По заявлению Intel, одна карта вмещает модели примерно до 300 млрд параметров, а система из восьми карт масштабируется за триллион параметров.
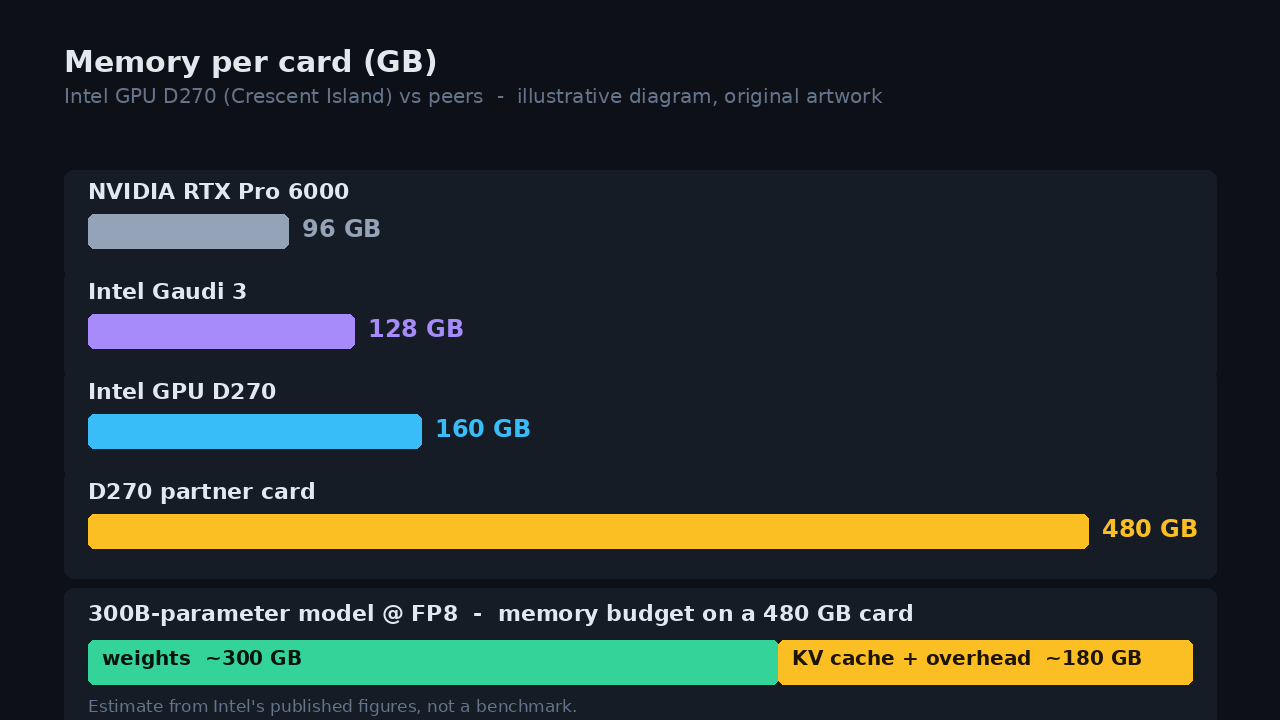
Компромисс заявлен открыто: LPDDR5X намного дешевле за гигабайт, её легче купить, она куда энергоэффективнее стековой HBM флагманских ИИ-чипов — но и заметно медленнее. Gaudi 3, нынешняя инференс-карта самой Intel, несёт 128 ГБ HBM2e при 3,7 ТБ/с; RTX Pro 6000 от Nvidia сочетает 96 ГБ GDDR7 примерно с 1,8 ТБ/с. D270 предлагает до пятикратной памяти RTX Pro 6000 при сопоставимой пропускной способности. Intel позиционирует ёмкость на ватт — и на доллар — как показатель, важный для инференса с тяжёлым декодированием, важнее пиковой пропускной способности.
Почему агенты так прожорливы к памяти
Продуктовая логика Intel исходит из того, что агенты делают на самом деле. Агент для кода или исследований держит в контексте длинную историю — часто 100 000 токенов и больше — и снова и снова вызывает модель на протяжении тысяч шагов. Каждый вызов начинается с префилла, где модель обрабатывает весь промпт, затем переходит к декодированию, генерируя ответ токен за токеном. Весь этот контекст живёт в KV-кэше — памяти модели о каждом уже виденном токене, — и кэш растёт с длиной контекста и числом одновременно обслуживаемых пользователей.
Арифметика памяти делает цифру 480 ГБ осязаемой. В точности FP8 каждый параметр занимает примерно один байт, поэтому плотной модели на 300 млрд параметров нужно около 300 ГБ только под веса — остаётся примерно 180 ГБ под KV-кэш, более длинные контексты и накладные расходы на карте 480 ГБ. Честный предел работает и в обратную сторону: при декодировании плотная модель должна прочитать все активные веса один раз на токен, поэтому при 1,5 ТБ/с один поток плотной 300B-модели упирается примерно в пять токенов в секунду. Это оценки из опубликованных цифр Intel, а не бенчмарки; реальные развёртывания пакетируют множество пользователей, а большинство крупных моделей используют архитектуры mixture-of-experts, где на токен активна лишь доля параметров.
Вся ставка — в одном предложении: для растущей доли инференс-нагрузок важнее, сколько помещается на карту, чем скорость каждого байта. Когда кэш перестаёт помещаться, провайдер вынужден распределять работу по большему числу карт, отбрасывать контекст — или и то, и другое, — а агенты с их длинными контекстами и повторными вызовами упираются в эту стену первыми.
От карты к стойке: системный взгляд
D270 — не единственный анонс Intel. Компания показала стоечные решения Xeon 6+, многие по стандарту OCP Open Rack v3, где самые плотные конфигурации масштабируются за 46 000 CPU-ядер на стойку при 133,45 кВт суммарной мощности. Тезис Intel: агенты выполняют огромный объём работы, которая вовсе не является инференсом модели, — маршрутизация запросов, запуск инструментов, выполнение кода, поиск по базам данных, перемещение данных.
Отсюда самая интересная строка пресс-релиза: по мере развития ИИ-инфраструктуры производительность всё чаще измеряется числом одновременных агентов, которое стойка выдерживает при целевой задержке. Intel также отметила работу в группе OCP Open Adapter Card — вместе с AMD, Dell, Nvidia и Qualcomm — над стандартизацией промежуточного форм-фактора карт-ускорителей между обычной PCIe-картой и полной стойкой.
В софте Intel опирается на общую Xe-базу, как у остальных своих GPU, обещает нативную интеграцию с vLLM и экосистемой PyTorch и поддержку новых открытых моделей с первого дня, начиная с 30-миллиардной Muse Glimmer от Meta. Её AI for Enterprise Agent Toolkit уже работает на процессорах Xeon; поддержка GPU запланирована, но пока недоступна, — программная оговорка, за которой стоит следить.
Чего мы пока не знаем
Пробелы велики, и Intel их не то чтобы скрывает — она их просто не заполнила. Нет цены, а это главное для карты, которая продаёт себя стоимостью за гигабайт и за токен. Отбор образцов идёт у производителей серверов, облачных провайдеров и софтверных компаний, но даты общей доступности нет. Нет опубликованных цифр токенов в секунду для конкретных моделей и независимых бенчмарков; никто, кроме Intel и её клиентов по семплированию, карту не тестировал.
А заголовочные 480 ГБ зависят от того, решат ли партнёры строить такие карты, — у самой Intel карта на 160 ГБ. Прежние попытки Intel в области дата-центровых GPU, от Ponte Vecchio до Gaudi, с трудом отвоёвывали долю у Nvidia, поэтому слайд экосистемы с 53 логотипами партнёров и работа над Linux-драйверами важны не меньше, чем таблица характеристик.
Что это значит
Для многих компаний счёт за эксплуатацию ИИ теперь важнее счёта за обучение, а агенты раздувают его длинными контекстами и повторными вызовами модели. Более дешёвая карта с воздушным охлаждением и большим объёмом памяти могла бы позволить предприятиям, государственным облакам и небольшим провайдерам запускать крупные открытые модели на железе, которое реально можно купить и запитать, — не раскидывая их по множеству дорогих GPU.
Для экосистемы открытых моделей одна карта, вмещающая 300-миллиардную модель, материально упрощает приватное развёртывание: сильные модели с открытыми весами работают локально, под контролем владельца, — это хорошо для суверенитета данных и конкуренции на рынке, где предложение HBM и цены Nvidia задают правила почти для всех.
Диагноз верен: агенты прожорливы к памяти, а HBM — самая дорогая и дефицитная по поставкам часть ИИ-железа. Но без цены, без независимых цифр токенов и с опцией 480 ГБ в руках партнёров D270 остаётся сильным слайдом, а не доказанным продуктом. Если Intel выкатит конкурентную цену, а поддержка vLLM будет твёрдой с первого дня, это может стать первой ИИ-картой Intel, которую покупатели действительно захотят. Вердикт вынесут независимые бенчмарки.
Источники и дополнительные материалы
Владелец проверил записи источников; независимая проверка фактов или моделью не заявляется.
- официальный пресс-релиз Intel
Intel Corporation
Recorded publication date ·
Recorded verification time ·
- технический разбор djcroman
djcroman
Recorded publication date ·
Recorded verification time ·
- Superpower Daily
Superpower Daily
Recorded publication date ·
Recorded verification time ·