

الإبداع وسير العمل
Hy Memory 2.0 من تينسنت: ذاكرة مفتوحة المصدر لوكلاء الذكاء الاصطناعي، ونموذج صغير لإدارتها
نموذج بنحو 3B معامل نشط يتولى كتابة الذاكرة التي كانت تقوم بها النماذج العامة. أرقام تينسنت قوية؛ واختبار مستقل يُظهر أن الجودة تُشترى لحظة الكتابة.
صياغة بمساعدة Muse؛ راجع المالك الحقائق والترجمات الثماني. هذه ليست مراجعة مستقلة بواسطة نموذج. كُتب هذا المقال بمساعدة الذكاء الاصطناعي ولم يخضع لمراجعة مستقلة. الأرقام بيانات منشورة من تينسنت ومعلومات أطراف ثالثة موسومة بوضوح؛ ونتائج القياس قياسات خاصة بالشركة لم تُتحقق بشكل مستقل.
ما الذي صدر
في 16 أكتوبر 2026، رقّى فريق Hunyuan في تينسنت إطار عمل ذاكرة الوكلاء إلى Hy Memory 2.0 وفتح مصدر الحزمة كاملة: نموذج ذاكرة متخصص، وإطار عمل الذاكرة نفسه، وMemHub — تطبيق يشارك ذاكرة واحدة عبر أدوات الذكاء الاصطناعي. الطبقات الثلاث برخصة Apache 2.0 ويمكن استخدامها منفصلة أو مجتمعة. وتقول الشركة إن Hy Memory يعمل بالفعل في قطاعاتها: المالية والأخبار وإدارة المعرفة ووكلاء المكاتب والترفيه الاجتماعي والألعاب.
أهمية الإصدار أن الذاكرة هي عنق الزجاجة الصامت للذكاء الاصطناعي الوكيل. الوكيل الذي يخطط ويبرمج ويراجع لساعات أو أيام يحتاج أن يتذكر ما حدث: تفضيلات المستخدم، والقرارات السابقة، والحقائق التي تغيرت. اليوم يتولى مهمة الكتابة عادةً النموذج العام الكبير نفسه الذي يفكر، بتوجيه من التعليمات. رهان تينسنت: إسناد المهمة إلى متخصص صغير.
ماذا يفعل نموذج 30B فعلا
Hy-Memory-30B-A3B نموذج خليط خبراء من 30 مليار معامل، بنحو 3 مليارات نشطة لكل رمز. مهمته واحدة فقط: مسار كتابة الذاكرة الخارجية. يقرر أي المعلومات يحتفظ بها من المحادثة، وبأي دقة يمثلها، وكيف يجب أن تُحدِّث الأدلة الجديدة بنك الذاكرة الدائم. صُمم بديلا مباشرا للنموذج العام الذي يقوم بهذه الكتابة اليوم داخل أطر Mem0 وMemOS وHy-Memory — وتقول تينسنت إنه ينتقل إلى أطر لم يرها في التدريب مثل EverMemOS.
يُدرَّب على مرحلتين. أولا، التقطير السياسي للذاكرة (Memory On-Policy Distillation) يعلّم النموذج بروتوكول الكتابة الخاص بكل إطار باستخدام حالات ولّدها النموذج نفسه. ثم يعمل التعلم المعزز للذاكرة المنسوبة على تحسين القدرة على الإجابة عن الأسئلة المستقبلية، بفحص كل مقطع ذاكرة ونسب المكافآت عبر المقاطع. التقرير التقني منشور كورقة arXiv.
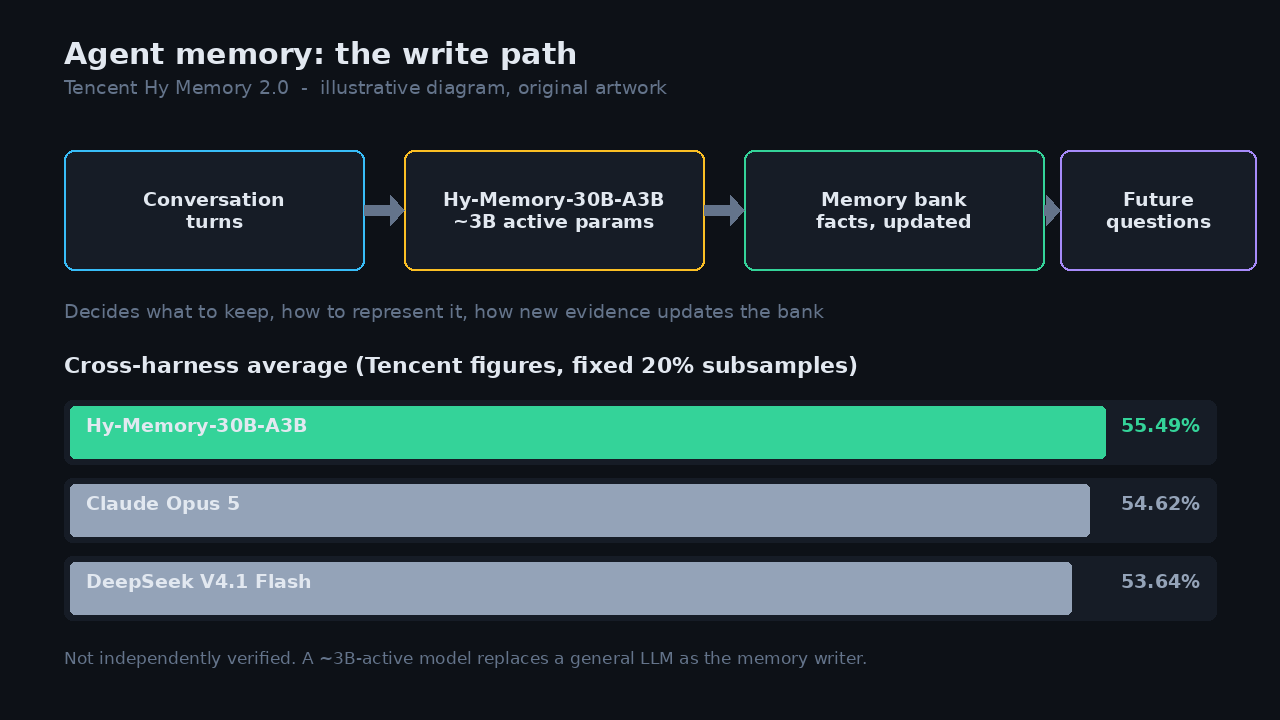
الحجة العملية هي التكلفة. نموذج بثلاثة مليارات معامل نشط يكتب الذاكرة أرخص تشغيلا بكثير من نموذج عام رائد — وحمل الكتابة ثابت: كل محادثة، وكل مستخدم، وكل يوم.
القياسات — وما لا تقوله
تذكر بطاقة نموذج تينسنت متوسطا عبر الأطر 55.49%، متقدما على 54.62% لـ Claude Opus 5 و53.64% لـ DeepSeek V4.1 Flash. الدرجة متوسط ستة قياسات — منها LongMemEval وLoCoMo — عبر أربعة أطر ذاكرة، كل منها مُقيَّم على عينة ثابتة 20% من بيانات الاختبار. هذه أرقام الشركة نفسها؛ ولم تُتحقق بشكل مستقل.
الهامش الصادق أهم من العنوان. عينات ثابتة 20%، وأطر اختارتها تينسنت، وتقييم أجرته تينسنت — الإعداد مصمم لإظهار النموذج في أفضل صورة. هذا لا يجعل الأرقام مزيفة؛ بل يجعلها نقطة بداية لا حكما نهائيا.
الادعاء الأعمق معماري لا رقمي: كتابة الذاكرة مهارة متميزة يمكن أن يمتلكها متخصص صغير. إن صح ذلك، حصل كل إطار وكلاء على طبقة ذاكرة أرخص وقابلة للتبديل — الغريزة نفسها التي تُبقي طبقة الاستدلال قابلة للتبديل. لكن المتخصص لا يكون جيدا إلا بقدر توزيع تدريبه، ومن هنا أهمية الفحص المستقل.
ماذا وجد الاختبار المستقل
في الأسبوع نفسه، اختبر مطور مستقل إطار Hy-Memory (الإصدار 2.0.1) على LongMemEval، مركزا على إخفاقين: الحقائق القديمة والنسبة المنسية. مع نموذج رخيص يكتب، أجاب النظام صحيحا عن 43% من 60 سؤالا — وسجل 0% في الأسئلة التي وردت إجابتها فقط فيما قاله المساعد نفسه.
مع Claude Opus 5.5 كاتبا، تغيرت الصورة: 9 من 10 في الحقائق المحدّثة، متساويا مع نظام المختبر نفسه الذي لا يستخدم LLM عند الكتابة. لكن الثمن كان نحو 5 دولارات لكل سجل مستخدم من 50 محادثة: 92 استدعاء LLM و695 ألف رمز إدخال. وخلص المختبر إلى أن الجودة تُشترى لحظة الكتابة.
الآلية هي المقايضة نفسها. يضغط Hy-Memory كل محادثة في عبارات مرتبة عن المستخدم — متخلصا مما لا يعده الكاتب حقيقة: توصيات المساعد نفسه، وتفاصيل بدت ثانوية، وأحيانا النسخة الأحدث من حقيقة. الاحتفاظ بالأدوار الخام مع الطوابع الزمنية يتجنب التخمين لكنه يكلف تخزينا وقراءة أكثر. لا تصميم خاطئ؛ بل يفشلان بشكل مختلف.
حزمة 2.0 وكيف تشغيلها
الطبقات الثلاث هي استراتيجية المنتج الحقيقية. النموذج يتولى الكتابة، والإطار يوفر آلية الذاكرة، وMemHub يشارك ذاكرة واحدة عبر الأدوات — كل منها صالح وحده أو مع غيره. كلها Apache 2.0، أي استخدام تجاري دون شروط مرتبطة بالإيرادات كما في بعض إصدارات الأوزان المفتوحة.
النشر ممل عن قصد: ثبّت عبر vLLM (مُختبَر مع v0.31.0)، ونادِ واجهة متوافقة مع OpenAI، ووجّهها إلى إطارك. الشيفرة على github.com/Tencent-Hunyuan/Hy-Memory والتقرير التقني على arXiv 2610.22196.
ماذا يعني ذلك
لبناة الوكلاء، يُشرعن الإصدار تقسيم عمل جديدا: متخصص رخيص يكتب الذاكرة، والنموذج الكبير يفكر. لا يؤتي هذا التقسيم ثماره إلا إذا كان الكاتب جيدا بما يكفي لبياناتك — وهو بالضبط ما قاسه الاختبار المستقل.
لمشهد أطر الذاكرة — Mem0 وMemOS وغيرهما — كاتب محمول برخصة مفتوحة ينتقل عبر الأطر يخفض تكلفة التبديل. وينتقل الخندق من الكاتب إلى تصميم الاسترجاع والتسوية.
الرد الصحيح على عنوان 55.49% هو قائمة المختبر: جرّبه على محادثاتك، وقس أي كاتب تحتاج وكم يكلف لكل مستخدم، واسأل هل يحتفظ بما قاله المساعد — لأن «بماذا أوصيتني آخر مرة؟» سؤال يطرحه المستخدمون الحقيقيون. المصدر المفتوح يجعل هذا الواجب ممكنا؛ ولا يؤديه عنك.
المصادر وقراءات إضافية
راجع المالك سجلات المصادر؛ ولا يُدّعى إجراء تحقق مستقل من الحقائق أو مراجعة مستقلة بواسطة نموذج.
- بطاقة نموذج Tencent Hunyuan (Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- التقرير التقني arXiv
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- تحليل AlexTech.ai
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- اختبار مستقل من كاتب dev.to
DEV Community
Recorded publication date ·
Recorded verification time ·
- تقرير Longbridge / Wallstreetcn
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·