

Création et processus de travail
Hy Memory 2.0 de Tencent : une mémoire open source pour les agents, et un petit modèle pour la gérer
Un modèle d'environ 3B de paramètres actifs reprend le travail d'écriture mémoire jusque-là confié aux LLM généralistes. Les chiffres de Tencent sont solides ; un test indépendant montre que la qualité s'achète au moment de l'écriture.
Rédaction assistée par Muse ; le propriétaire a relu les faits et les huit traductions. Il ne s’agit pas d’une révision indépendante par un modèle. Cet article a été rédigé avec l'assistance de l'IA et n'a pas été vérifié de façon indépendante. Les chiffres sont les données publiées par Tencent et des informations tierces clairement étiquetées ; les benchmarks sont les mesures propres de l'entreprise, non vérifiées indépendamment.
Ce qui a été publié
Le 16 octobre 2026, l'équipe Hunyuan de Tencent a fait passer son framework de mémoire pour agents à Hy Memory 2.0 et a ouvert l'ensemble de la pile : un modèle de mémoire spécialisé, le framework de mémoire lui-même et MemHub, une application qui partage une même mémoire entre outils IA. Les trois couches sont publiées sous licence Apache 2.0 et peuvent être utilisées séparément ou combinées. Selon l'entreprise, Hy Memory est déjà en service dans ses activités finance, news, gestion des connaissances, agents de bureau, divertissement social et jeux.
Cette sortie compte parce que la mémoire est le goulot silencieux de l'IA agentique. Un agent qui planifie, code et révise pendant des heures ou des jours doit se souvenir de ce qui s'est passé : préférences utilisateur, décisions antérieures, faits qui ont changé. Aujourd'hui, ce travail d'écriture est généralement assuré par le même grand modèle généraliste qui réfléchit, guidé par des prompts. Le pari de Tencent : le confier à un petit spécialiste.
Ce que fait vraiment le modèle 30B
Hy-Memory-30B-A3B est un modèle à mélange d'experts de 30 milliards de paramètres, dont environ 3 milliards actifs par token. Il n'a qu'un seul travail : le chemin d'écriture de la mémoire externe. Il décide quelles informations retenir d'une conversation, avec quelle précision les représenter et comment les nouvelles preuves doivent mettre à jour la banque de mémoire persistante. Il est conçu comme un remplacement direct du LLM généraliste qui assure aujourd'hui cette écriture dans les frameworks Mem0, MemOS et Hy-Memory — et Tencent affirme qu'il se transfère à des frameworks jamais vus à l'entraînement, comme EverMemOS.
Il est entraîné en deux étapes. D'abord, la distillation de politiques en mémoire (Memory On-Policy Distillation) apprend au modèle le protocole d'écriture de chaque framework à partir d'états générés par le modèle lui-même. Ensuite, l'apprentissage par renforcement de mémoire attribuée optimise la capacité à répondre aux questions futures, en évaluant chaque fragment de mémoire et en attribuant les récompenses entre fragments. Le rapport technique est publié en preprint arXiv.
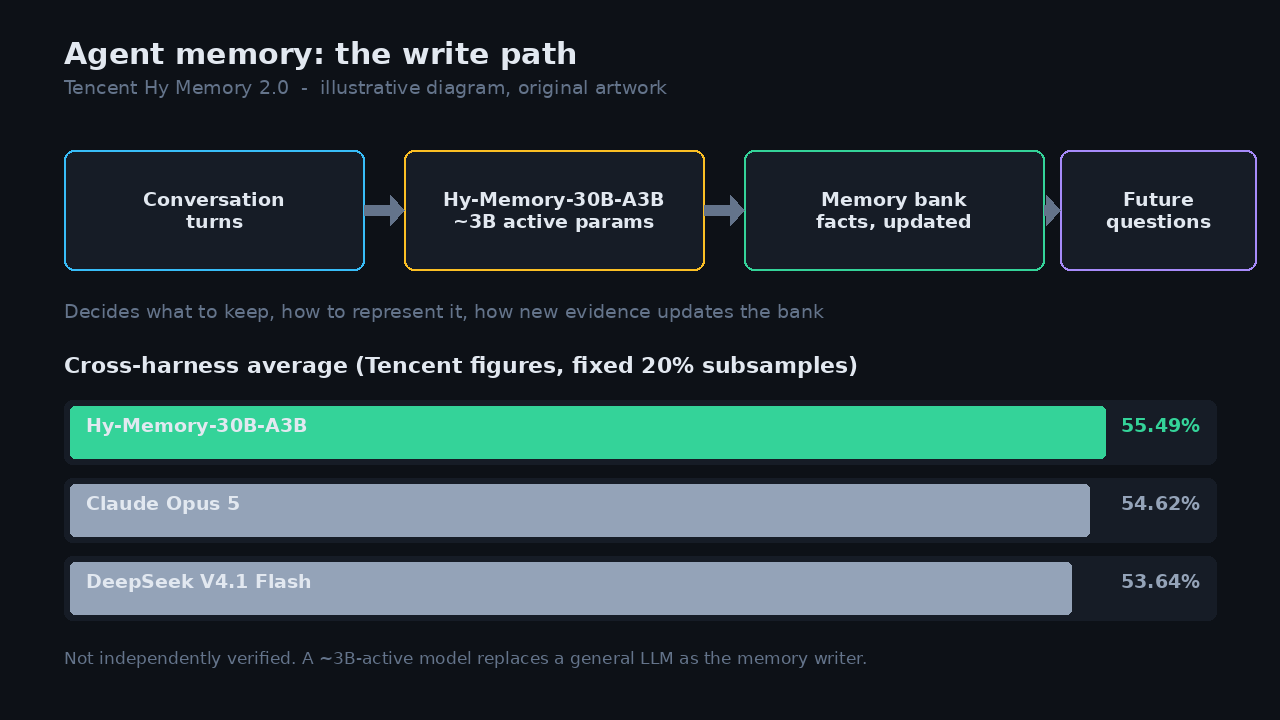
L'argument pratique, c'est le coût. Un modèle à 3 milliards de paramètres actifs qui écrit la mémoire coûte bien moins cher à exploiter qu'un modèle généraliste phare — et la charge d'écriture est constante : chaque conversation, chaque utilisateur, chaque jour.
Les benchmarks — et ce qu'ils ne disent pas
La fiche modèle de Tencent rapporte une moyenne inter-frameworks de 55,49 %, devant les 54,62 % de Claude Opus 5 et les 53,64 % de DeepSeek V4.1 Flash. Le score moyenne six benchmarks — dont LongMemEval et LoCoMo — sur quatre frameworks de mémoire, chacun évalué sur un sous-échantillon fixe de 20 % des données. Ce sont les chiffres propres de l'entreprise ; ils n'ont pas été vérifiés de façon indépendante.
La note honnête compte plus que le titre. Sous-échantillons fixes de 20 %, frameworks choisis par Tencent, évaluation menée par Tencent : la configuration est conçue pour montrer le modèle sous son meilleur jour. Cela ne rend pas les chiffres faux ; cela en fait un point de départ, pas un verdict.
L'affirmation profonde est architecturale, pas numérique : l'écriture mémoire est une compétence distincte qu'un petit spécialiste peut posséder. Si c'est vrai, chaque framework d'agents obtient une couche mémoire moins chère et interchangeable — le même instinct qui garde la couche d'inférence interchangeable. Mais un spécialiste n'est bon que dans la mesure de sa distribution d'entraînement, d'où l'importance de la vérification indépendante.
Ce que le test indépendant a trouvé
La même semaine, un développeur indépendant a testé le framework Hy-Memory (version 2.0.1) sur LongMemEval, en se concentrant sur deux échecs : les faits périmés et l'attribution oubliée. Avec un modèle bon marché à l'écriture, le système a répondu correctement à 43 % de 60 questions — et a obtenu 0 % sur les questions dont la réponse n'apparaissait que dans ce que l'assistant lui-même avait dit.
Avec Claude Opus 5.5 comme rédacteur, le tableau a changé : 9 sur 10 sur les faits mis à jour, à égalité avec le système de l'évaluateur qui n'utilise aucun LLM à l'écriture. Mais le prix était d'environ 5 dollars par historique de 50 conversations : 92 appels LLM et 695 000 tokens d'entrée. La qualité, a conclu l'évaluateur, s'achète au moment de l'écriture.
Le mécanisme, c'est le compromis. Hy-Memory compresse chaque conversation en affirmations bien rangées sur l'utilisateur — ce qui écarte tout ce que le rédacteur ne considère pas comme un fait : les propres recommandations de l'assistant, des détails jugés mineurs, parfois la version la plus récente d'un fait. Conserver les tours bruts horodatés évite les conjectures, mais coûte plus de stockage et de lecture. Aucun design n'est faux ; ils échouent différemment.
Le pack 2.0 et comment l'exécuter
Les trois couches sont la vraie stratégie produit. Le modèle gère l'écriture, le framework fournit la machinerie mémoire et MemHub partage une mémoire entre outils — chacun utilisable seul ou ensemble. Le tout est sous Apache 2.0, ce qui autorise un usage commercial sans les conditions liées au chiffre d'affaires de certaines publications de poids ouverts.
Le déploiement est délibérément ennuyeux : installation via vLLM (testé avec v0.31.0), appel à une API compatible OpenAI, branchement sur votre framework. Le code est sur github.com/Tencent-Hunyuan/Hy-Memory et le rapport technique sur arXiv 2610.22196.
Ce que cela signifie
Pour les bâtisseurs d'agents, cette sortie légitime une nouvelle division du travail : un spécialiste bon marché écrit la mémoire, le grand modèle réfléchit. Cette division ne paie que si le rédacteur est assez bon pour vos données — c'est exactement ce que le test indépendant a mesuré.
Pour le paysage des frameworks de mémoire — Mem0, MemOS et les autres —, un rédacteur portable sous licence ouverte, transférable entre frameworks, réduit le coût de changement. Le fossé se déplace du rédacteur vers la conception de la récupération et de la réconciliation.
La bonne réponse au titre des 55,49 %, c'est la check-list de l'évaluateur : testez sur vos propres conversations, mesurez quel rédacteur il vous faut et ce qu'il coûte par utilisateur, et demandez s'il conserve ce que l'assistant a dit — parce que « que m'avais-tu recommandé la dernière fois ? » est une question que les vrais utilisateurs posent. L'open source rend ce devoir possible ; il ne le fait pas à votre place.
Sources et lectures
Le propriétaire a relu les références ; aucune vérification indépendante des faits ni révision indépendante par un modèle n’est revendiquée.
- fiche modèle de Tencent Hunyuan (Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- rapport technique arXiv
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- analyse d'AlexTech.ai
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- test indépendant de l'auteur dev.to
DEV Community
Recorded publication date ·
Recorded verification time ·
- reportage Longbridge / Wallstreetcn
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·