

Criação e fluxos de trabalho
Hy Memory 2.0 da Tencent: memória open-source para agentes, com um modelo pequeno para cuidar dela
Um modelo de ~3B de parâmetros ativos assume a escrita de memória antes feita por LLMs gerais. Os números da Tencent são fortes; um teste independente mostra que a qualidade se compra na hora de escrever.
Redação assistida por Muse; o proprietário revisou os fatos e as oito traduções. Não se trata de revisão independente por um modelo. Este artigo foi escrito com assistência de IA e não foi revisado de forma independente. Os números são dados publicados pela Tencent e informações de terceiros claramente rotuladas; os benchmarks são medições próprias da empresa, não verificadas de forma independente.
O que foi lançado
Em 16 de outubro de 2026, a equipe Hunyuan da Tencent atualizou seu framework de memória para agentes para o Hy Memory 2.0 e abriu todo o stack: um modelo de memória especializado, o próprio framework de memória e o MemHub, um app que compartilha uma mesma memória entre ferramentas de IA. As três camadas usam a licença Apache 2.0 e podem ser usadas separadamente ou combinadas. Segundo a empresa, o Hy Memory já opera em seus negócios de finanças, notícias, gestão do conhecimento, agentes de escritório, entretenimento social e games.
O lançamento importa porque a memória é o gargalo silencioso da IA agêntica. Um agente que planeja, programa e revisa por horas ou dias precisa lembrar o que aconteceu: preferências do usuário, decisões anteriores, fatos que mudaram. Hoje esse trabalho de escrita costuma ser feito pelo mesmo grande modelo geral que pensa, guiado por prompts. A aposta da Tencent: entregá-lo a um pequeno especialista.
O que o modelo de 30B realmente faz
O Hy-Memory-30B-A3B é um modelo de mistura de especialistas de 30 bilhões de parâmetros com cerca de 3 bilhões ativos por token. Ele tem um único trabalho: o caminho de escrita da memória externa. Decide quais informações reter de uma conversa, com que precisão representá-las e como novas evidências devem atualizar o banco de memória persistente. Foi desenhado como substituto direto do LLM geral que hoje faz essa escrita dentro dos frameworks Mem0, MemOS e Hy-Memory — e a Tencent afirma que ele se transfere para frameworks não vistos no treino, como o EverMemOS.
Ele é treinado em duas etapas. Primeiro, a destilação de políticas em memória (Memory On-Policy Distillation) ensina ao modelo o protocolo de escrita de cada framework usando estados gerados pelo próprio modelo. Depois, o aprendizado por reforço de memória atribuída otimiza a capacidade de responder perguntas futuras, avaliando cada bloco de memória e atribuindo recompensas entre blocos. O relatório técnico foi publicado como preprint no arXiv.
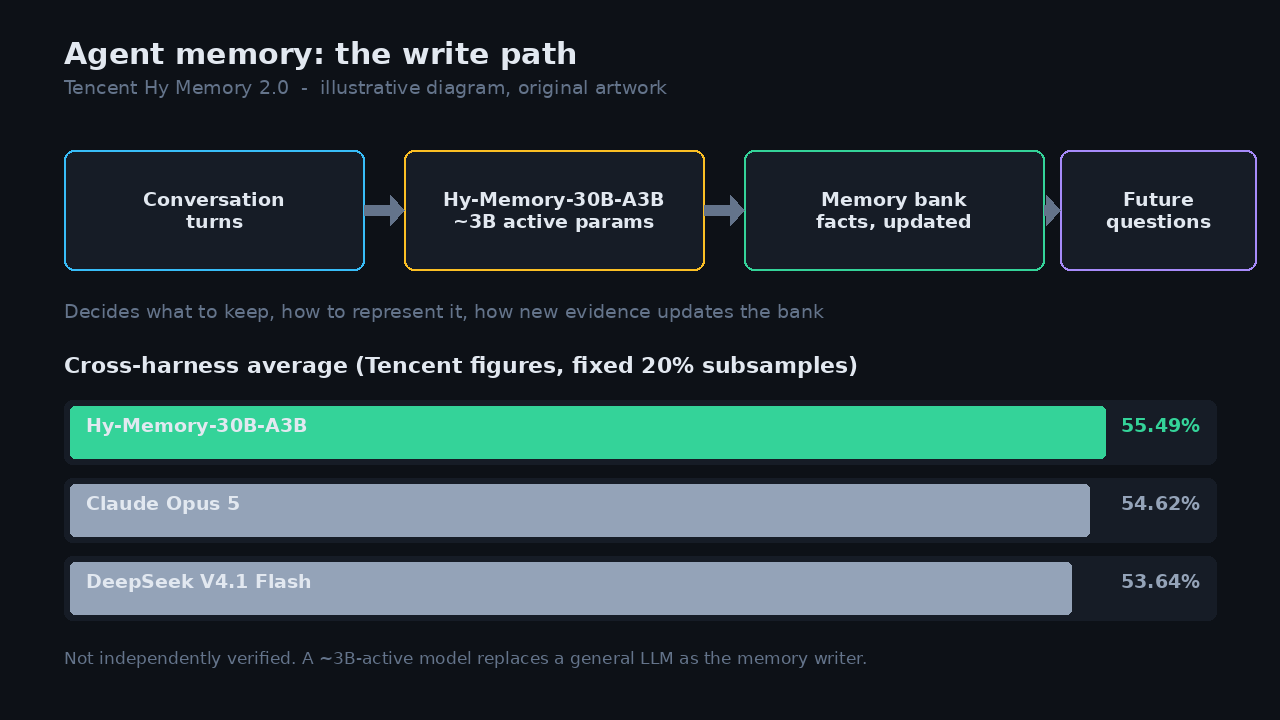
O argumento prático é custo. Um modelo de 3 bilhões de parâmetros ativos escrevendo memória custa muito menos para operar do que um modelo geral de ponta — e a carga de escrita é constante: cada conversa, cada usuário, cada dia.
Os benchmarks — e o que eles não dizem
A ficha do modelo da Tencent reporta uma média entre frameworks de 55,49%, à frente dos 54,62% do Claude Opus 5 e dos 53,64% do DeepSeek V4.1 Flash. A pontuação média seis benchmarks — incluindo LongMemEval e LoCoMo — em quatro frameworks de memória, cada um avaliado numa subamostra fixa de 20% dos dados. São números próprios da empresa; não foram verificados de forma independente.
A nota honesta importa mais que a manchete. Subamostras fixas de 20%, frameworks escolhidos pela Tencent, avaliação executada pela Tencent: a configuração foi desenhada para mostrar o melhor do modelo. Isso não torna os números falsos; torna-os um ponto de partida, não um veredito.
A afirmação profunda é arquitetural, não numérica: escrever memória é uma habilidade distinta que um pequeno especialista pode dominar. Se for verdade, cada framework de agentes ganha uma camada de memória mais barata e intercambiável — o mesmo instinto que mantém a camada de inferência intercambiável. Mas um especialista só é tão bom quanto sua distribuição de treino, por isso a verificação independente importa.
O que o teste independente encontrou
Na mesma semana, um desenvolvedor independente testou o framework Hy-Memory (versão 2.0.1) no LongMemEval, focando em duas falhas: fatos desatualizados e atribuição esquecida. Com um modelo barato escrevendo, o sistema respondeu corretamente 43% de 60 perguntas — e zerou nas perguntas cuja resposta aparecia só no que o próprio assistente havia dito.
Com o Claude Opus 5.5 como escritor, o quadro mudou: 9 de 10 em fatos atualizados, igualando o sistema do avaliador que não usa LLM ao escrever. Mas o preço foi cerca de US$ 5 por histórico de 50 conversas: 92 chamadas ao LLM e 695 mil tokens de entrada. A qualidade, concluiu o avaliador, se compra na hora de escrever.
O mecanismo é o compromisso. O Hy-Memory comprime cada conversa em afirmações arrumadas sobre o usuário — o que descarta o que o escritor não considera um fato: as próprias recomendações do assistente, detalhes que pareciam menores, às vezes a versão nova de um fato. Guardar os turnos crus com timestamps evita adivinhações, mas custa mais armazenamento e leitura. Nenhum desenho está errado; eles falham de jeitos diferentes.
O pacote 2.0 e como rodá-lo
As três camadas são a verdadeira estratégia de produto. O modelo cuida da escrita, o framework traz a maquinaria de memória e o MemHub compartilha uma memória entre ferramentas — cada um usável sozinho ou em conjunto. Tudo é Apache 2.0, o que permite uso comercial sem as condições atreladas a receita de alguns lançamentos de pesos abertos.
A implantação é deliberadamente sem graça: instala-se com vLLM (testado com v0.31.0), chama-se uma API compatível com OpenAI e aponta-se para seu framework. O código está em github.com/Tencent-Hunyuan/Hy-Memory e o relatório técnico no arXiv 2610.22196.
O que isso significa
Para quem constrói agentes, o lançamento legitima uma nova divisão do trabalho: um especialista barato escreve a memória, o modelo grande pensa. Essa divisão só compensa se o escritor for bom o bastante para os seus dados — que é exatamente o que o teste independente mediu.
Para o cenário de frameworks de memória — Mem0, MemOS e afins —, um escritor portátil de licença aberta que se transfere entre frameworks reduz o custo de troca. O fosso se move do escritor para o desenho de recuperação e reconciliação.
A resposta certa à manchete de 55,49% é a lista do avaliador: rode nas suas próprias conversas, meça de qual escritor você precisa e quanto custa por usuário, e pergunte se ele guarda o que o assistente disse — porque 'o que você me recomendou da última vez?' é uma pergunta que usuários reais fazem. O código aberto torna essa lição de casa possível; não a faz por você.
Fontes e leituras
O proprietário revisou os registros de fontes; não se afirma verificação independente dos fatos nem revisão independente por um modelo.
- ficha do modelo da Tencent Hunyuan (Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- relatório técnico do arXiv
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- análise da AlexTech.ai
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- teste independente do autor do dev.to
DEV Community
Recorded publication date ·
Recorded verification time ·
- reportagem da Longbridge / Wallstreetcn
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·