

Kreation und Arbeitsabläufe
Tencents Hy Memory 2.0: Open-Source-Gedächtnis für KI-Agenten – mit einem kleinen Modell als Verwalter
Ein Modell mit ~3B aktiven Parametern übernimmt das Schreiben von Gedächtnis, das bisher allgemeine LLMs erledigten. Tencents Zahlen sind stark; ein unabhängiger Test zeigt: Qualität wird beim Schreiben gekauft.
Entwurf mit Unterstützung von Muse; der Eigentümer hat die Fakten und alle acht Übersetzungen geprüft. Dies ist keine unabhängige Modellprüfung. Dieser Artikel wurde mit KI-Unterstützung geschrieben und nicht unabhängig geprüft. Zahlen sind Tencents veröffentlichte Daten und klar gekennzeichnete Drittinformationen; die Benchmarks sind eigene Messungen des Unternehmens, nicht unabhängig verifiziert.
Was veröffentlicht wurde
Am 16. Oktober 2026 hat Tencents Hunyuan-Team sein Agenten-Gedächtnis-Framework auf Hy Memory 2.0 aktualisiert und den gesamten Stack geöffnet: ein spezialisiertes Gedächtnismodell, das Memory-Framework selbst und MemHub, eine App, die ein Gedächtnis über KI-Tools hinweg teilt. Alle drei Schichten stehen unter der Apache-2.0-Lizenz und lassen sich einzeln oder kombiniert nutzen. Laut Unternehmen ist Hy Memory bereits in seinen Geschäftsbereichen im Einsatz – von Finanzen und News über Wissensmanagement und Büro-Agenten bis zu Social Entertainment und Gaming.
Der Release ist wichtig, weil Gedächtnis der stille Engpass agentischer KI ist. Ein Agent, der stunden- oder tagelang plant, codiert und überarbeitet, muss sich erinnern, was geschehen ist: Nutzerpräferenzen, frühere Entscheidungen, veränderte Fakten. Heute erledigt diese Schreibarbeit meist dasselbe große Generalistenmodell, das auch denkt – per Prompt gesteuert. Tencents Wette: Gib den Job einem kleinen Spezialisten.
Was das 30B-Modell tatsächlich tut
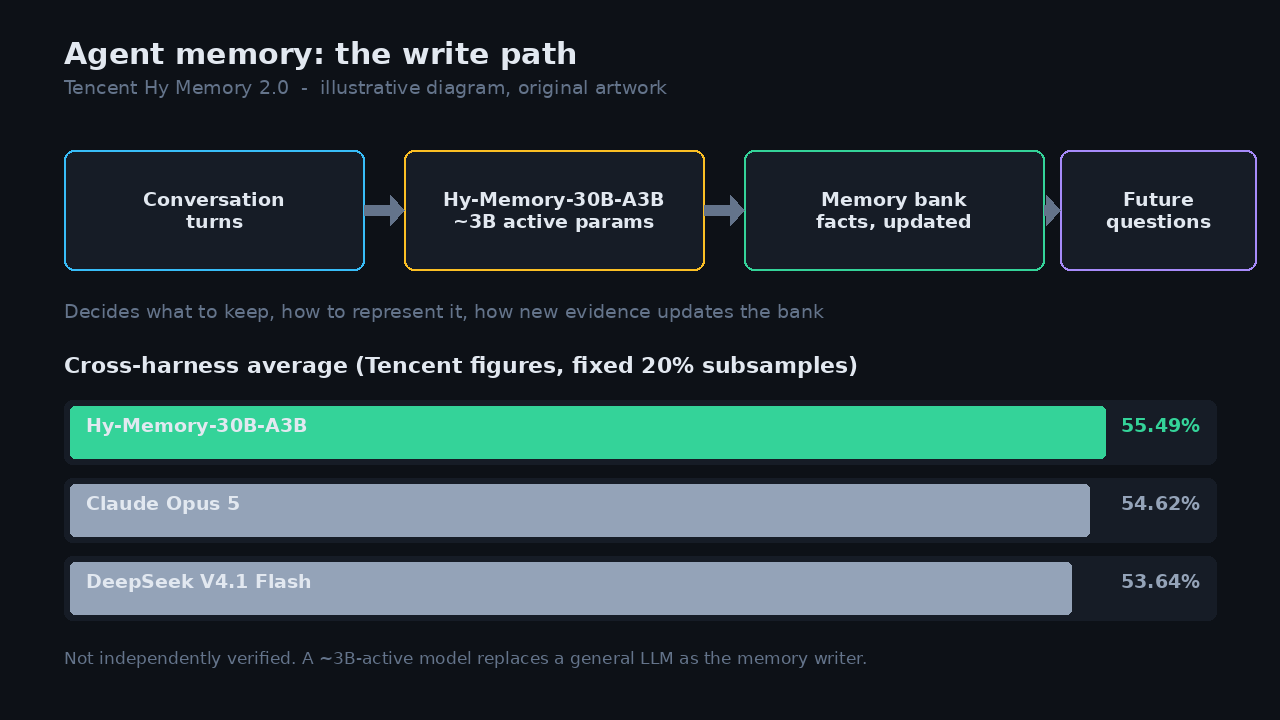
Hy-Memory-30B-A3B ist ein Mixture-of-Experts-Modell mit 30 Milliarden Parametern, davon etwa 3 Milliarden aktiv pro Token. Es hat genau einen Job: den Schreibpfad des externen Gedächtnisses. Es entscheidet, welche Informationen aus einem Gespräch behalten werden, wie präzise sie dargestellt werden und wie neue Evidenz die persistente Gedächtnisbank aktualisieren soll. Es ist als direkter Ersatz für das Generalisten-LLM gedacht, das dieses Schreiben derzeit in den Frameworks Mem0, MemOS und Hy-Memory übernimmt – und laut Tencent überträgt es sich auf Frameworks, die es im Training nie gesehen hat, etwa EverMemOS.
Trainiert wird in zwei Stufen. Zuerst lehrt Memory On-Policy Distillation dem Modell das Schreibprotokoll jedes Frameworks anhand von Zuständen, die das Modell selbst erzeugt hat. Dann optimiert Attributed Memory Reinforcement Learning die Fähigkeit, künftige Fragen zu beantworten, indem es jeden Gedächtnis-Chunk prüft und Rewards über Chunks hinweg attribuiert. Der technische Bericht ist als arXiv-Preprint erschienen.
Das praktische Argument sind die Kosten. Ein Modell mit 3 Milliarden aktiven Parametern, das Gedächtnis schreibt, ist im Betrieb weit günstiger als ein Generalisten-Flaggschiff – und die Schreiblast ist konstant: jedes Gespräch, jeder Nutzer, jeden Tag.
Die Benchmarks – und was sie verschweigen
Tencents Model Card meldet einen frameworkübergreifenden Durchschnitt von 55,49 % – vor Claude Opus 5 mit 54,62 % und DeepSeek V4.1 Flash mit 53,64 %. Der Score mittelt sechs Benchmarks – darunter LongMemEval und LoCoMo – über vier Gedächtnis-Frameworks, jeweils evaluiert auf einer festen 20-%-Stichprobe der Testdaten. Das sind eigene Zahlen des Unternehmens; sie wurden nicht unabhängig verifiziert.
Die ehrliche Fußnote ist wichtiger als die Schlagzeile. Feste 20-%-Stichproben, von Tencent gewählte Frameworks, von Tencent durchgeführte Evaluation – das Setup ist darauf ausgelegt, das Modell von seiner besten Seite zu zeigen. Das macht die Zahlen nicht falsch; es macht sie zum Ausgangspunkt, nicht zum Urteil.
Die tiefere Behauptung ist architektonisch, nicht numerisch: Gedächtnis zu schreiben ist eine eigenständige Fähigkeit, die ein kleiner Spezialist beherrschen kann. Wenn das stimmt, bekommt jedes Agenten-Framework eine günstigere, austauschbare Gedächtnisschicht – derselbe Instinkt, der die Inferenzschicht austauschbar hält. Doch ein Spezialist ist nur so gut wie seine Trainingsverteilung, weshalb die unabhängige Prüfung zählt.
Was der unabhängige Test fand
In derselben Woche testete ein unabhängiger Entwickler das Hy-Memory-Framework (Version 2.0.1) auf LongMemEval, fokussiert auf zwei Fehlerarten: veraltete Fakten und vergessene Attribution. Mit einem billigen Modell als Schreiber beantwortete das System 43 % von 60 Fragen korrekt – und 0 % der Fragen, deren Antwort nur in dem vorkam, was der Assistent selbst gesagt hatte.
Mit Claude Opus 5.5 als Schreiber änderte sich das Bild: 9 von 10 bei aktualisierten Fakten – gleichauf mit dem eigenen System des Testers, das beim Schreiben ganz ohne LLM auskommt. Doch der Preis lag bei etwa 5 Dollar pro Nutzerhistorie aus rund 50 Gesprächen: 92 LLM-Calls und 695.000 Input-Token. Qualität, so das Fazit des Testers, wird beim Schreiben gekauft.
Der Mechanismus ist der Kompromiss selbst. Hy-Memory komprimiert jedes Gespräch in ordentliche Aussagen über den Nutzer – und verwirft dabei alles, was der Schreiber nicht für einen Fakt hält: die eigenen Empfehlungen des Assistenten, scheinbar nebensächliche Details, manchmal die neuere Version eines Fakts. Rohe Turns mit Zeitstempeln zu behalten vermeidet das Raten, kostet aber mehr Speicher und Leseaufwand. Kein Design ist falsch; sie scheitern nur unterschiedlich.
Das 2.0-Paket und wie man es betreibt
Die drei Schichten sind die eigentliche Produktstrategie. Das Modell übernimmt den Schreibpfad, das Framework liefert die Gedächtnismaschinerie, und MemHub teilt ein Gedächtnis über Tools hinweg – einzeln oder kombiniert nutzbar. Alles unter Apache 2.0, also kommerziell nutzbar ohne die umsatzgebundenen Bedingungen mancher Open-Weight-Releases.
Das Deployment ist bewusst langweilig: per vLLM installieren (getestet mit v0.31.0), eine OpenAI-kompatible API aufrufen, aufs eigene Framework zeigen. Der Code liegt auf github.com/Tencent-Hunyuan/Hy-Memory, der technische Bericht unter arXiv 2610.22196.
Was das bedeutet
Für Agentenbauer legitimiert der Release eine neue Arbeitsteilung: Ein günstiger Spezialist schreibt das Gedächtnis, das große Modell denkt. Diese Teilung zahlt sich nur aus, wenn der Schreiber gut genug für die eigenen Daten ist – genau das hat der unabhängige Test gemessen.
Für die Landschaft der Gedächtnis-Frameworks – Mem0, MemOS und Co. – senkt ein portabler, offen lizenzierter Schreiber, der sich über Frameworks hinweg überträgt, die Wechselkosten. Der Burggraben wandert vom Schreiber zum Retrieval- und Abgleichsdesign.
Die richtige Antwort auf die 55,49-%-Schlagzeile ist die Checkliste des Testers: auf den eigenen Gesprächen laufen lassen, messen, welchen Schreiber man braucht und was er pro Nutzer kostet, und fragen, ob er behält, was der Assistent gesagt hat – denn „was hast du mir letztes Mal empfohlen?" ist eine Frage, die echte Nutzer stellen. Open Source macht diese Hausaufgabe möglich; es erledigt sie nicht für einen.
Quellen und weitere Lektüre
Der Eigentümer hat die Quellenangaben geprüft; eine unabhängige Fakten- oder Modellprüfung wird nicht behauptet.
- Modellkarte von Tencent Hunyuan (Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- technischer arXiv-Bericht
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- AlexTech.ai-Analyse
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- unabhängiger Test des dev.to-Autors
DEV Community
Recorded publication date ·
Recorded verification time ·
- Longbridge-/Wallstreetcn-Bericht
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·