

Творчество и рабочие процессы
Hy Memory 2.0 от Tencent: открытая память для ИИ-агентов и небольшая модель для её ведения
Модель с ~3B активных параметров забирает у общих LLM работу по записи памяти. Цифры Tencent выглядят сильно; независимая проверка показывает: качество покупается в момент записи.
Текст подготовлен с помощью Muse; владелец проверил факты и все восемь переводов. Это не независимая проверка моделью. Статья написана при помощи ИИ и не проходила независимую проверку. Цифры — опубликованные данные Tencent и чётко помеченная сторонняя информация; бенчмарки — собственные замеры компании, независимо не проверены.
Что выпущено
16 октября 2026 года команда Hunyuan компании Tencent обновила фреймворк памяти для агентов до Hy Memory 2.0 и открыла весь стек: специализированную модель памяти, сам фреймворк памяти и MemHub — приложение, которое делит одну память между ИИ-инструментами. Все три слоя выпущены под лицензией Apache 2.0 и могут использоваться по отдельности или вместе. По заявлению компании, Hy Memory уже работает в её бизнесах — от финансов и новостей до офисных агентов и игр.
Релиз важен, потому что память — тихий узкое место агентного ИИ. Агент, который планирует, пишет код и правит его часами или днями, должен помнить, что происходило: предпочтения пользователя, прежние решения, изменившиеся факты. Сегодня эту работу по записи обычно выполняет та же большая общая модель, что и думает, — по промптам. Ставка Tencent: отдать её маленькому специалисту.
Что на самом деле делает модель 30B
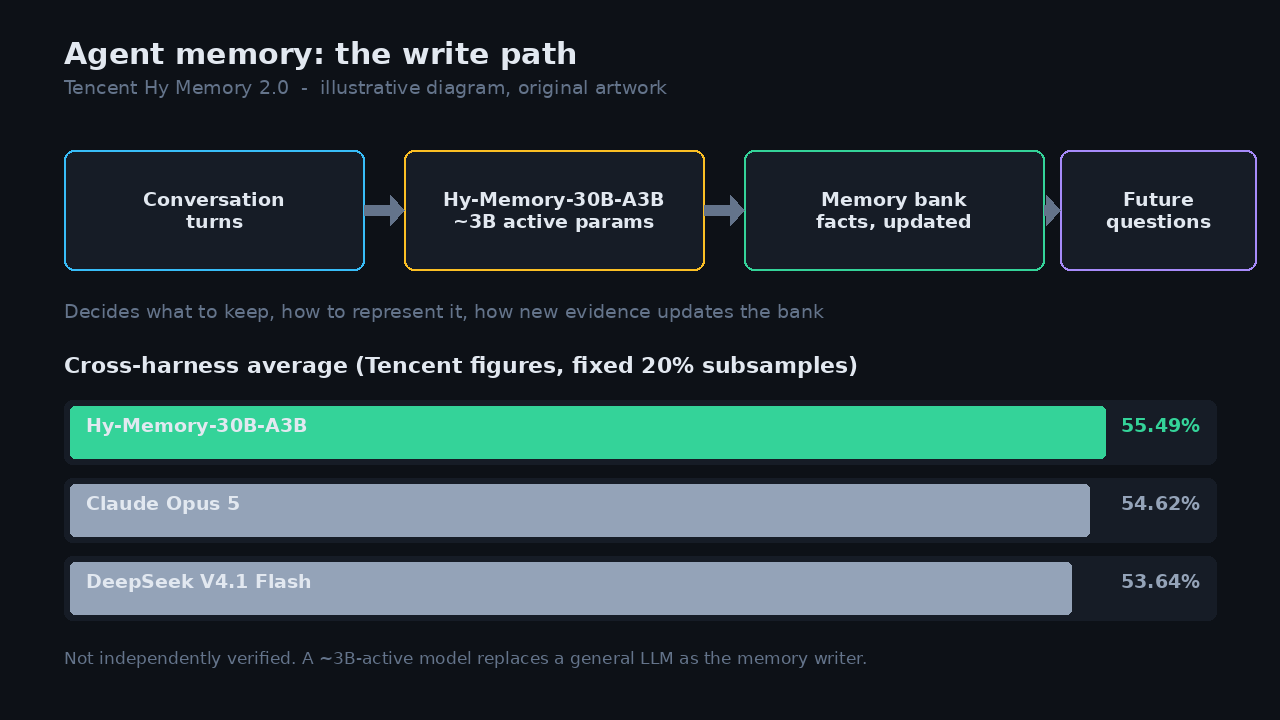
Hy-Memory-30B-A3B — модель mixture-of-experts на 30 млрд параметров, около 3 млрд активных на токен. У неё ровно одна работа: путь записи внешней памяти. Она решает, какую информацию сохранить из диалога, насколько точно её представить и как новые свидетельства должны обновить постоянный банк памяти. Она задумана как прямая замена LLM общего назначения, который сегодня выполняет эту запись внутри фреймворков Mem0, MemOS и Hy-Memory, — и, по заявлению Tencent, переносится на фреймворки, которых не видела в обучении, например EverMemOS.
Обучение идёт в два этапа. Сначала Memory On-Policy Distillation учит модель протоколу записи каждого фреймворка на состояниях, сгенерированных самой моделью. Затем Attributed Memory Reinforcement Learning оптимизирует способность отвечать на будущие вопросы, проверяя каждый чанк памяти и атрибутируя награды между чанками. Технический отчёт опубликован как препринт arXiv.
Практический аргумент — стоимость. Модель с 3 млрд активных параметров, пишущая память, стоит в эксплуатации куда дешевле флагманской общей модели, — а нагрузка на запись постоянна: каждый диалог, каждый пользователь, каждый день.
Бенчмарки — и то, о чём они молчат
В модельной карте Tencent заявлен средний кросс-фреймворк результат 55,49% — выше, чем у Claude Opus 5 (54,62%) и DeepSeek V4.1 Flash (53,64%). Оценка усредняет шесть бенчмарков, включая LongMemEval и LoCoMo, по четырём фреймворкам памяти, каждый — на фиксированной 20%-й подвыборке тестовых данных. Это собственные цифры компании; независимо они не проверены.
Честная сноска важнее заголовка. Фиксированные 20%-е подвыборки, выбранные Tencent фреймворки, оценка, проведённая Tencent, — конфигурация задумана показать модель с лучшей стороны. Это не делает цифры фальшивыми; это делает их отправной точкой, а не приговором.
Более глубокое утверждение — архитектурное, а не численное: запись памяти — отдельный навык, которым может владеть маленький специалист. Если это так, каждый агентный фреймворк получает более дешёвый заменяемый слой памяти — тот же инстинкт, что держит заменяемым слой инференса. Но специалист хорош лишь настолько, насколько хорошо его распределение обучения, — поэтому независимая проверка и важна.
Что показал независимый тест
На той же неделе независимый разработчик прогнал фреймворк Hy-Memory (версия 2.0.1) через LongMemEval, сфокусировавшись на двух сбоях: устаревших фактах и забытой атрибуции. С дешёвой моделью в роли писателя система правильно ответила на 43% из 60 вопросов — и набрала 0% на вопросах, ответы на которые встречались только в том, что говорил сам ассистент.
С Claude Opus 5.5 в роли писателя картина изменилась: 9 из 10 на обновлённых фактах — наравне с собственной системой тестировщика, вообще не использующей LLM при записи. Но цена составила около $5 на историю пользователя из ~50 диалогов: 92 вызова LLM и 695 000 входных токенов. Качество, заключил тестировщик, покупается в момент записи.
Механизм — в самом компромиссе. Hy-Memory сжимает каждый диалог в аккуратные утверждения о пользователе — отбрасывая всё, что писатель не счёл фактом: собственные рекомендации ассистента, казавшиеся мелкими детали, иногда новую версию факта. Хранение сырых реплик с временными метками избавляет от догадок, но стоит дороже в хранении и чтении. Ни один дизайн не ошибочен; они просто отказывают по-разному.
Пакет 2.0 и как это запустить
Три слоя — и есть настоящая продуктовая стратегия. Модель ведёт запись, фреймворк даёт механизм памяти, а MemHub делит одну память между инструментами — каждый из которых может использоваться по отдельности или вместе. Всё под Apache 2.0, то есть коммерческое использование без привязанных к выручке условий, как у некоторых открытых релизов весов.
Развёртывание нарочито скучное: установка через vLLM (протестировано на v0.31.0), вызов OpenAI-совместимого API, привязка к своему фреймворку. Код — на github.com/Tencent-Hunyuan/Hy-Memory, технический отчёт — arXiv 2610.22196.
Что это значит
Для строителей агентов релиз легитимирует новое разделение труда: дешёвый специалист пишет память, большая модель думает. Это разделение окупается, только если писатель достаточно хорош для ваших данных, — а это ровно то, что измерил независимый тест.
Для ландшафта фреймворков памяти — Mem0, MemOS и других — переносимый писатель с открытой лицензией, работающий поверх разных харнессов, снижает стоимость перехода. Ров смещается от писателя к дизайну поиска и сверки.
Правильный ответ на заголовок про 55,49% — чек-лист тестировщика: прогоните на своих диалогах, измерьте, какой писатель вам нужен и сколько он стоит на пользователя, и спросите, сохраняет ли он то, что говорил сам ассистент, — потому что «что ты мне рекомендовал в прошлый раз?» — вопрос, который реальные пользователи задают. Открытый код делает эту домашнюю работу возможной; он не делает её за вас.
Источники и дополнительные материалы
Владелец проверил записи источников; независимая проверка фактов или моделью не заявляется.
- модельная карта Tencent Hunyuan (Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- технический отчёт arXiv
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- разбор AlexTech.ai
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- независимый тест автора dev.to
DEV Community
Recorded publication date ·
Recorded verification time ·
- репортаж Longbridge / Wallstreetcn
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·