

创作与工作流
腾讯 Hy Memory 2.0:给智能体一个开源的“记忆”,再配一个小模型来打理它
约 3B 激活参数的小模型接管了原本由通用大模型做的记忆写入工作。腾讯的数字很亮眼;独立测试表明,记忆的质量是在写入时用钱买来的。
Muse 辅助起草;事实与八语译文均由所有者审阅。这不是独立模型复审。 本文由 AI 辅助撰写,未经独立审查。数字为腾讯已发布数据及明确标注的第三方信息;跑分结果为腾讯自测,未经独立验证。
发布了什么
2026 年 10 月 16 日,腾讯混元团队把智能体记忆框架升级到 Hy Memory 2.0,并把整套技术栈全部开源:一个专职记忆模型、记忆框架本身,以及 MemHub——一个让多个 AI 工具共享同一份记忆的应用。三层全部采用 Apache 2.0 许可,可独立使用,也可组合成完整记忆方案。腾讯称 Hy Memory 已在其金融、新闻、知识管理、办公智能体、社交娱乐和游戏等多条业务线落地。
这次发布的意义在于,记忆是智能体 AI 安静的瓶颈。一个规划、写代码、反复修改、持续工作数小时甚至数天的智能体,必须记得发生过什么——用户偏好、此前的决策、已经变化的事实。今天这份“写记忆”的工作,通常由同一个做思考的大通用模型顺手完成。腾讯的赌注是:把这份工作交给一个小专职模型。
这个 30B 模型到底是做什么的
Hy-Memory-30B-A3B 是一个 300 亿参数的混合专家模型,每个 token 约 30 亿激活参数。它只有一份工作:外部记忆的写入路径。它决定从对话中保留什么信息、以多精确的形式表达、以及新证据如何更新长期记忆库。它的定位是直接替换目前在 Mem0、MemOS、Hy-Memory 等框架里负责写记忆的通用大模型——腾讯还称,它能迁移到训练时没见过的框架,比如 EverMemOS。
它的训练分两阶段。第一阶段“记忆在线策略蒸馏”让模型学会每个框架的写入协议,用的还是模型自己生成的状态;第二阶段“归因记忆强化学习”则以答对未来问题为目标,对每个记忆块打分、跨块归因奖励。技术报告已作为 arXiv 预印本发布。
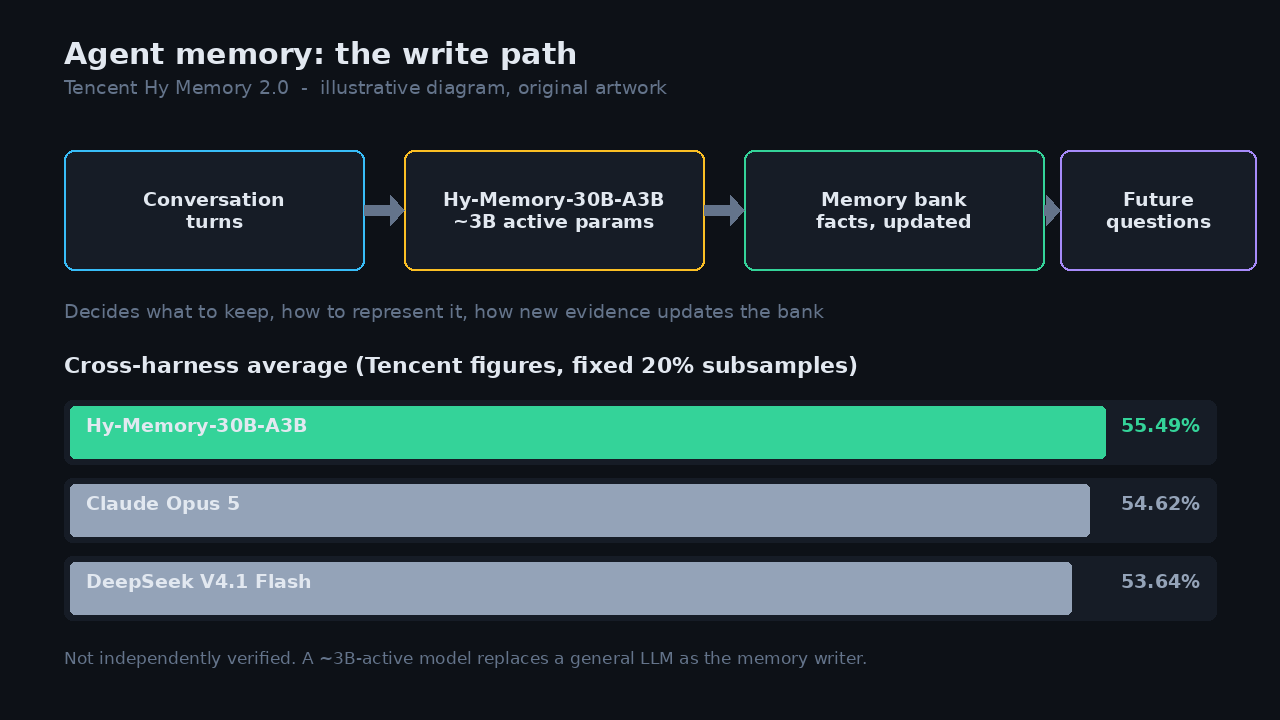
实际的卖点是成本。一个 30 亿激活参数的模型做写入,运行成本远低于旗舰通用模型——而写记忆的工作量是恒定的:每段对话、每个用户、每一天。
跑分,以及跑分没说的话
腾讯的模型卡报告了 55.49% 的跨框架平均分,高于 Claude Opus 5 的 54.62% 和 DeepSeek V4.1 Flash 的 53.64%。这个分数是六个基准(含 LongMemEval、LoCoMo)在四个记忆框架上的平均,每个都在固定 20% 测试子集上评估。这是腾讯自己的数字,未经独立验证。
诚实的脚注比标题更重要。固定的 20% 子集、腾讯自选的框架、腾讯自己跑的评估——这套配置天然会把模型最好的一面展示出来。这不意味着数字造假,只意味着它是起点,不是定论。
更深的主张不在数字而在架构:写记忆是一项独立技能,可以交给小专职模型。如果成立,每个智能体框架都能换上更便宜、可替换的记忆层——和“推理层要可替换”是同一个逻辑。但专职模型的好坏取决于它的训练分布,所以独立检验才重要。
独立实测发现了什么
同一周,一位独立开发者用 LongMemEval 测试了 Hy-Memory 框架(2.0.1 版),聚焦两类失败:过时的事实和被遗忘的归属。用便宜模型做写入时,系统在 60 道题里答对 43%——而答案只出现在“助手自己说过的话”里的题目,得分是 0%。
换成 Claude Opus 5.5 做写入,局面变了:更新事实 10 题对 9 题,追平了测试者自己那套写入时不用 LLM 的系统。但代价是每份约 50 段对话的用户历史约 5 美元——92 次 LLM 调用、69.5 万输入 token。测试者的结论是:质量是在写入时买来的。
机制就是取舍本身。Hy-Memory 把每段对话压缩成关于用户的整齐陈述——这会丢掉写作者不认为是“事实”的东西:助手自己的建议、看似次要的细节、有时甚至是事实的新版本。保留带时间戳的原始轮次能避免猜测,但存储和阅读成本更高。两种设计都没错,只是失败的方式不同。
2.0 三件套与怎么跑起来
三层分工才是真正的产品策略:模型负责写入路径,框架提供记忆机制,MemHub 让多个工具共享同一份记忆——可单独用,也可组合。全部 Apache 2.0,意味着商用没有某些开放权重发布里按营收设门槛的附加条件。
部署刻意做得很无聊:用 vLLM 装(已测 v0.31.0),调 OpenAI 兼容 API,对接到你的框架就行。代码在 github.com/Tencent-Hunyuan/Hy-Memory,技术报告在 arXiv 2610.22196。
意味着什么
对智能体开发者,这次发布让一种新的分工合法化:便宜的专职模型写记忆,大模型负责思考。这种分工划算的前提,是写作者在你的数据上足够好——而这正是独立测试量的东西。
对记忆框架的格局(Mem0、MemOS 等),一个可移植、开源许可、能跨框架迁移的写作者降低了切换成本。护城河从“写作者”移到了检索与对账的设计上。
面对 55.49% 的标题,正确的回应是测试者的清单:在你自己的对话上跑一遍,量出你需要什么样的写作者、每个用户多少钱,再问一句:它保不保留助手自己说过的话——因为“你上次推荐的是什么?”是真实用户会问的问题。开源让这份功课成为可能,但不会替你做完。
资料来源与延伸阅读
来源记录由所有者审阅;不声称已完成独立事实核验或独立模型复审。
- 腾讯混元模型卡(Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- arXiv 技术报告
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- AlexTech.ai 解析
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- dev.to 作者独立实测
DEV Community
Recorded publication date ·
Recorded verification time ·
- Longbridge / 华尔街见闻报道
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·