

Creación y flujos de trabajo
Hy Memory 2.0 de Tencent: memoria de código abierto para agentes, con un modelo pequeño para gestionarla
Un modelo de ~3B de parámetros activos toma el trabajo de escribir memoria que antes hacían los LLM generales. Las cifras de Tencent son sólidas; una prueba independiente muestra que la calidad se compra al escribir.
Redacción asistida por Muse; el propietario revisó los hechos y las ocho traducciones. No es una revisión independiente por un modelo. Este artículo fue escrito con asistencia de IA y no fue revisado de forma independiente. Las cifras son datos publicados por Tencent e información de terceros claramente etiquetada; los benchmarks son mediciones propias de la empresa, no verificadas de forma independiente.
Qué se lanzó
El 16 de octubre de 2026, el equipo Hunyuan de Tencent actualizó su framework de memoria para agentes a Hy Memory 2.0 y liberó todo el stack: un modelo de memoria especializado, el propio framework de memoria y MemHub, una app que comparte una misma memoria entre herramientas de IA. Las tres capas usan la licencia Apache 2.0 y pueden usarse por separado o combinadas. Según la empresa, Hy Memory ya opera en sus negocios de finanzas, noticias, gestión del conocimiento, agentes de oficina, entretenimiento social y videojuegos.
El lanzamiento importa porque la memoria es el cuello de botella silencioso de la IA agéntica. Un agente que planifica, programa y revisa durante horas o días necesita recordar lo ocurrido: preferencias del usuario, decisiones previas, hechos que cambiaron. Hoy ese trabajo de escritura suele hacerlo el mismo gran modelo general que piensa, guiado por prompts. La apuesta de Tencent: dárselo a un pequeño especialista.
Qué hace realmente el modelo 30B
Hy-Memory-30B-A3B es un modelo de mezcla de expertos de 30.000 millones de parámetros con unos 3.000 millones activos por token. Tiene un único trabajo: la ruta de escritura de la memoria externa. Decide qué información conservar de una conversación, con qué precisión representarla y cómo la nueva evidencia debe actualizar el banco de memoria persistente. Está diseñado como reemplazo directo del LLM general que hoy hace esa escritura dentro de los frameworks Mem0, MemOS y Hy-Memory, y Tencent afirma que se transfiere a frameworks no vistos en el entrenamiento, como EverMemOS.
Se entrena en dos etapas. Primero, la destilación de políticas en memoria (Memory On-Policy Distillation) enseña al modelo el protocolo de escritura de cada framework usando estados generados por el propio modelo. Después, el aprendizaje por refuerzo de memoria atribuida optimiza la capacidad de responder preguntas futuras, evaluando cada fragmento de memoria y atribuyendo recompensas entre fragmentos. El informe técnico está publicado como preprint en arXiv.
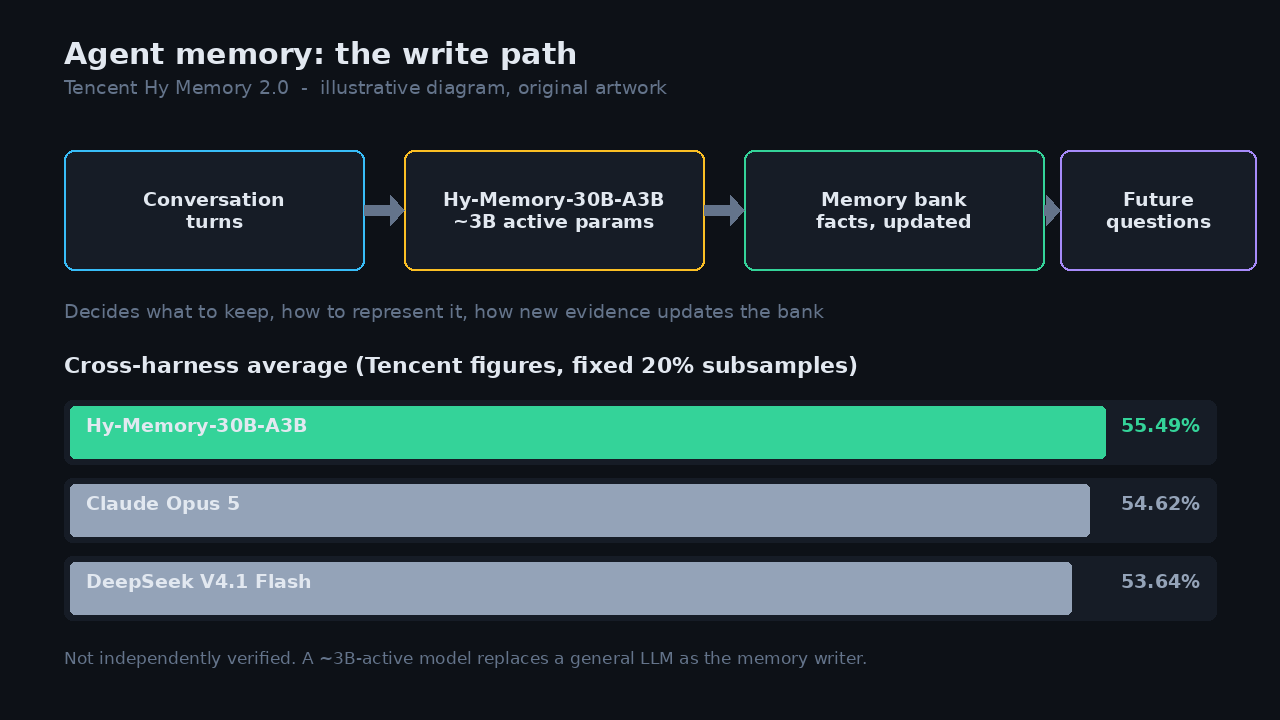
El argumento práctico es el costo. Un modelo de 3.000 millones de parámetros activos escribiendo memoria cuesta mucho menos de operar que un modelo general insignia, y la carga de escritura es constante: cada conversación, cada usuario, cada día.
Los benchmarks, y lo que no dicen
La tarjeta del modelo de Tencent reporta un promedio entre frameworks del 55,49%, por delante del 54,62% de Claude Opus 5 y el 53,64% de DeepSeek V4.1 Flash. La puntuación promedia seis benchmarks —incluidos LongMemEval y LoCoMo— en cuatro frameworks de memoria, cada uno evaluado en una submuestra fija del 20% de los datos. Son cifras propias de la empresa; no han sido verificadas de forma independiente.
La nota honesta importa más que el titular. Submuestras fijas del 20%, frameworks elegidos por Tencent, evaluación ejecutada por Tencent: la configuración está diseñada para mostrar lo mejor del modelo. Eso no hace falsos los números; los convierte en un punto de partida, no en un veredicto.
La afirmación profunda es arquitectónica, no numérica: escribir memoria es una habilidad distinta que un pequeño especialista puede dominar. Si es cierto, cada framework de agentes obtiene una capa de memoria más barata e intercambiable, el mismo instinto que mantiene intercambiable la capa de inferencia. Pero un especialista solo es tan bueno como su distribución de entrenamiento, por eso importa la verificación independiente.
Qué encontró la prueba independiente
La misma semana, un desarrollador independiente probó el framework Hy-Memory (versión 2.0.1) con LongMemEval, centrándose en dos fallos: hechos desactualizados y atribución olvidada. Con un modelo barato escribiendo, el sistema respondió correctamente el 43% de 60 preguntas, y obtuvo 0% en las preguntas cuya respuesta solo aparecía en lo que el propio asistente había dicho.
Con Claude Opus 5.5 como escritor, el panorama cambió: 9 de 10 en hechos actualizados, igualando el sistema del evaluador que no usa LLM al escribir. Pero el precio fue de unos 5 dólares por historial de 50 conversaciones: 92 llamadas al LLM y 695.000 tokens de entrada. La calidad, concluyó el evaluador, se compra al escribir.
El mecanismo es el compromiso. Hy-Memory comprime cada conversación en afirmaciones ordenadas sobre el usuario, lo que descarta lo que el escritor no considera un hecho: las propias recomendaciones del asistente, detalles que parecían menores, a veces la versión nueva de un hecho. Guardar los turnos crudos con marcas de tiempo evita las conjeturas, pero cuesta más almacenamiento y lectura. Ningún diseño es incorrecto; fallan de forma distinta.
El paquete 2.0 y cómo ejecutarlo
Las tres capas son la verdadera estrategia de producto. El modelo gestiona la escritura, el framework aporta la maquinaria de memoria y MemHub comparte una memoria entre herramientas, cada uno usable solo o en conjunto. Todo es Apache 2.0, lo que permite uso comercial sin las condiciones ligadas a ingresos de algunas publicaciones de pesos abiertos.
El despliegue es deliberadamente aburrido: se instala con vLLM (probado con v0.31.0), se llama a una API compatible con OpenAI y se apunta a tu framework. El código está en github.com/Tencent-Hunyuan/Hy-Memory y el informe técnico en arXiv 2610.22196.
Qué significa
Para quienes construyen agentes, el lanzamiento legitima una nueva división del trabajo: un especialista barato escribe la memoria, el modelo grande piensa. Esa división solo rinde si el escritor es lo bastante bueno para tus datos, que es justo lo que midió la prueba independiente.
Para el panorama de frameworks de memoria —Mem0, MemOS y compañía—, un escritor portable con licencia abierta que se transfiere entre frameworks reduce el costo de cambiar. El foso se mueve del escritor al diseño de recuperación y reconciliación.
La respuesta correcta al titular del 55,49% es la lista del evaluador: pruébalo en tus propias conversaciones, mide qué escritor necesitas y cuánto cuesta por usuario, y pregunta si conserva lo que dijo el asistente, porque '¿qué me recomendaste la última vez?' es una pregunta que los usuarios reales hacen. El código abierto hace posible esa tarea; no la hace por ti.
Fuentes y lecturas
El propietario revisó los registros de fuentes; no se afirma una verificación independiente de hechos ni una revisión independiente por un modelo.
- tarjeta del modelo de Tencent Hunyuan (Hugging Face)
Tencent Hunyuan (Hugging Face)
Recorded publication date ·
Recorded verification time ·
- informe técnico de arXiv
arXiv (Tencent Hunyuan)
Recorded publication date ·
Recorded verification time ·
- análisis de AlexTech.ai
AlexTech.ai
Recorded publication date ·
Recorded verification time ·
- prueba independiente del autor de dev.to
DEV Community
Recorded publication date ·
Recorded verification time ·
- reporte de Longbridge / Wallstreetcn
Longbridge (Wallstreetcn)
Recorded publication date ·
Recorded verification time ·